Nvidia выложила модель, которая слушает час записи и отвечает на вопросы по ней
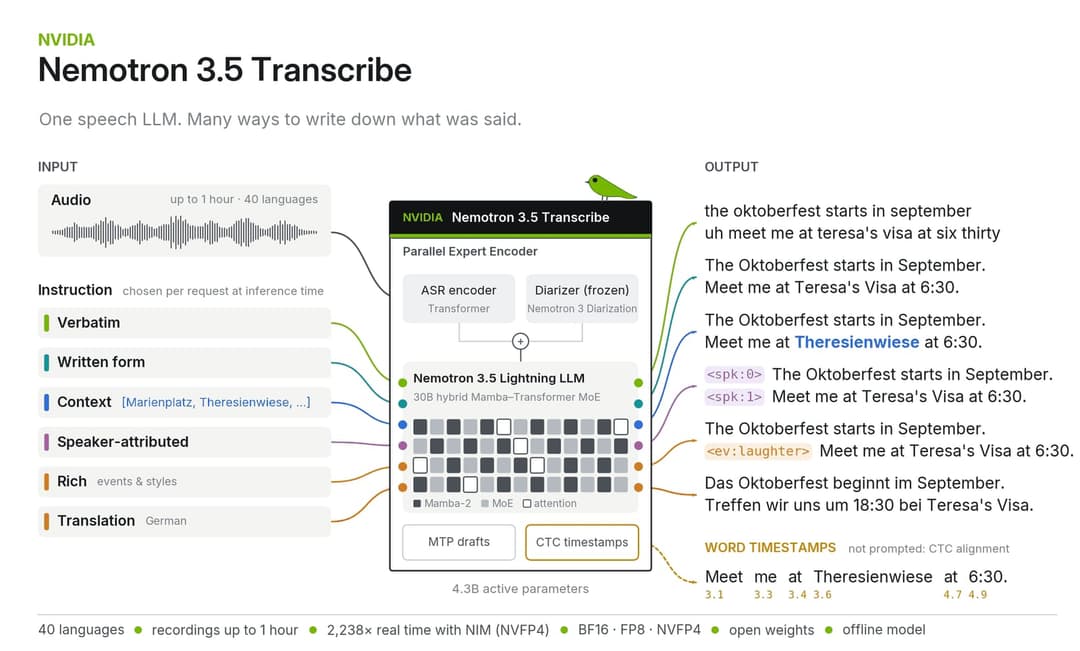
Одна и та же часовая запись встречи, три разных промпта. В первом случае на выходе транскрипт с метками спикеров. Во втором английский перевод. В третьем короткая выжимка: что решили и кто за что отвечает. Модель при этом одна. Это Nemotron 3.5 Transcribe, которую Nvidia в конце октября выложила в открытый доступ вместе с новой версией речевого датасета.
Главная идея в том, что распознавание речи здесь управляется текстом. Не набор отдельных режимов, а инструкция на человеческом языке. Можно подсунуть модели список терминов, скажем названия лекарств, и она будет использовать их, только если они действительно звучат в записи. Слово из подсказки не должно появиться в тексте просто потому, что оно есть в списке.
Раньше эту работу делили между несколькими моделями. Например, отдельная Nemotron 3 Diarization, вышедшая в сентябре, определяла до восьми спикеров в реальном времени, а сам текст писала другая модель вроде Parakeet. Теперь обе задачи в одной, плюс перевод и вопросы по содержанию записи.
Что внутри
- транскрибация на 40 языках;
- перевод с 31 языка на английский и обратно;
- определение спикеров в 13 языках, до 8 голосов в одной записи;
- записи длиной до часа;
- ответы на вопросы о том, что в записи прозвучало.
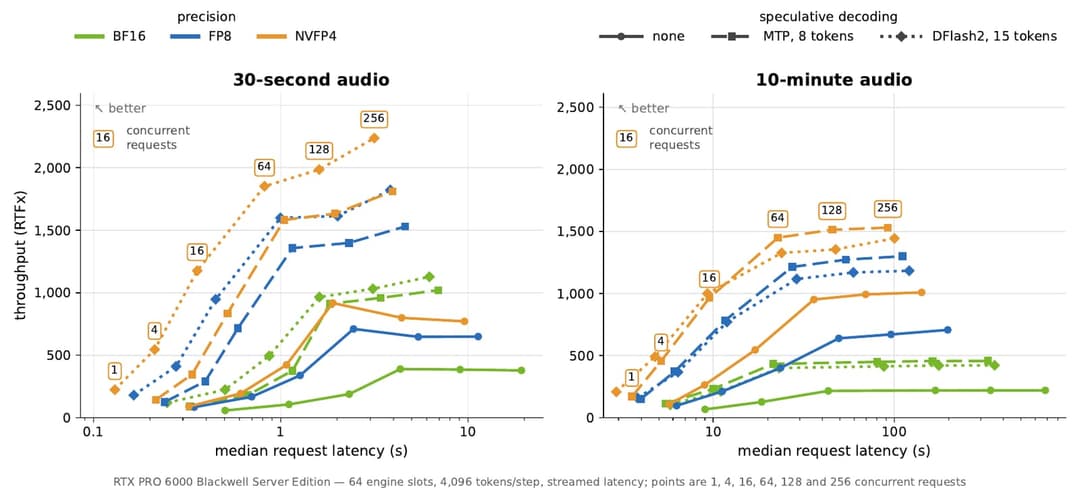
Всего в модели 30 млрд параметров, но на каждом шаге обработки работают около 4 млрд. Запускается она на одном GPU Nvidia, от компактного DGX Spark до датацентровых ускорителей. Среди платформ упоминается и Jetson AGX Thor, контроллер для робототехники. По данным компании, 100 часов аудио проходят менее чем за три минуты на RTX PRO 6000 Blackwell Server Edition при точности NVFP4. Это цифра самой Nvidia, независимо её пока не проверяли.
Цифры против конкурентов
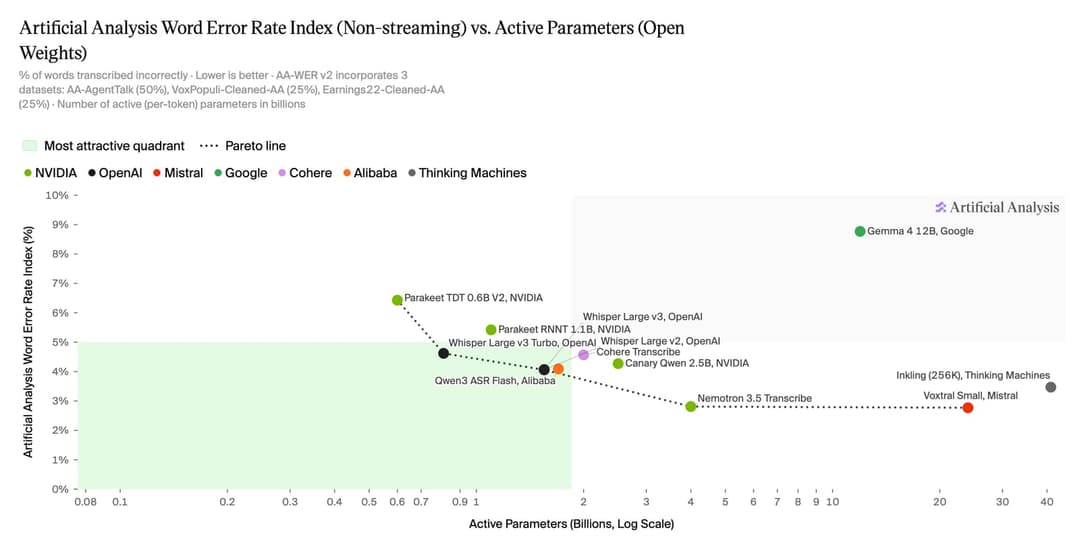
На английском в сравнении Artificial Analysis Nemotron почти не уступает модели втрое тяжелее. Чем меньше WER (доля ошибок в словах), тем лучше.
| Модель | Активные параметры | WER |
|---|---|---|
| Nemotron 3.5 Transcribe | ~4 млрд | 2,81% |
| Voxtral Small (Mistral) | ~24 млрд | 2,77% |
Разница в сотые доли процента при шестикратном перевесе в активных параметрах. Нас подкупила именно эта строка, а не первое место в рейтинге.
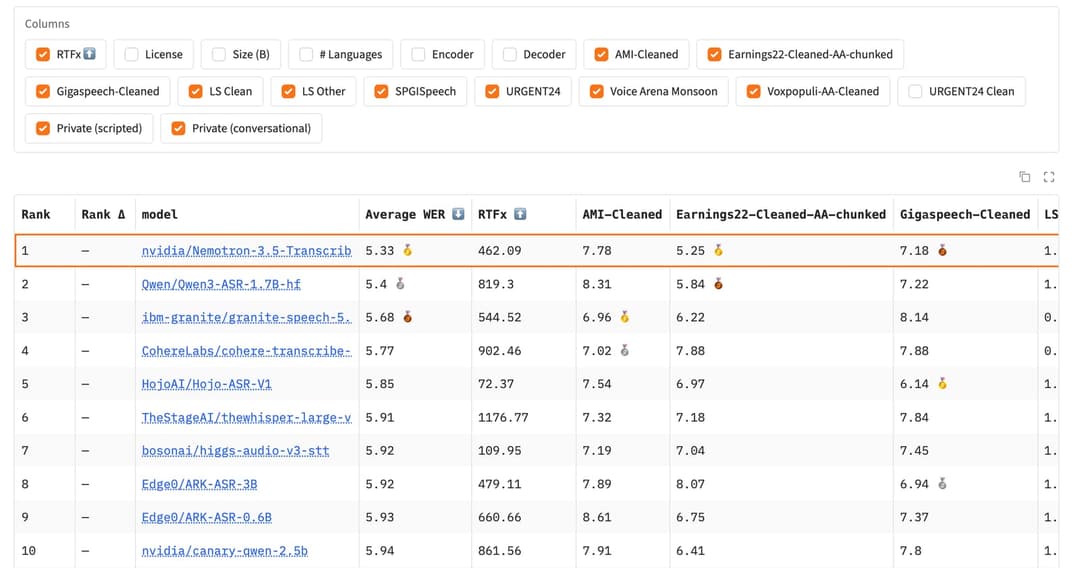
Рейтинг тоже есть. На Open ASR Leaderboard от Hugging Face модель стала первой среди открытых со средней WER 5,33%.
| Модель | Средняя WER |
|---|---|
| Nemotron 3.5 Transcribe | 5,33% |
| Qwen3-ASR-1.7B (Alibaba) | 5,4% |
| IBM Granite Speech | 5,68% |
Нвидиа утверждает, что несколько популярных коммерческих сервисов распознавания уступают новинке.
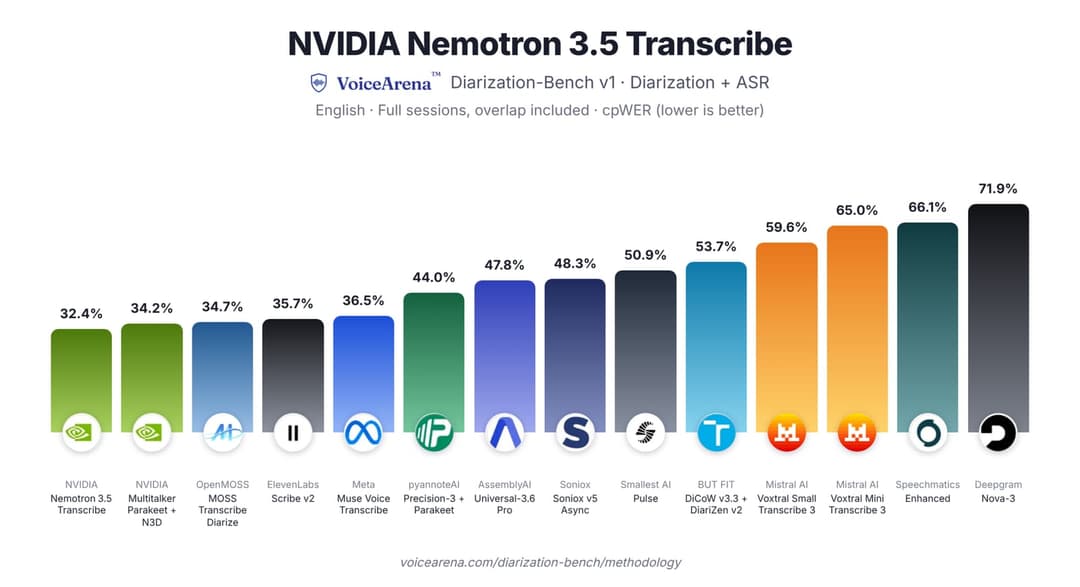
Отдельно проверяли разговоры, где люди перебивают друг друга. В тесте VoiceArena (Diarization-Bench v1, английский) из 14 систем модель оказалась первой по метрике cpWER, которая учитывает и слова, и то, кому они приписаны.
| Система | cpWER |
|---|---|
| Nemotron 3.5 Transcribe | 32,4% |
| Nvidia Multitalker Parakeet | 34,2% |
| MOSS Transcribe Diarize | 34,7% |
| Deepgram Nova-3 | 71,9% |
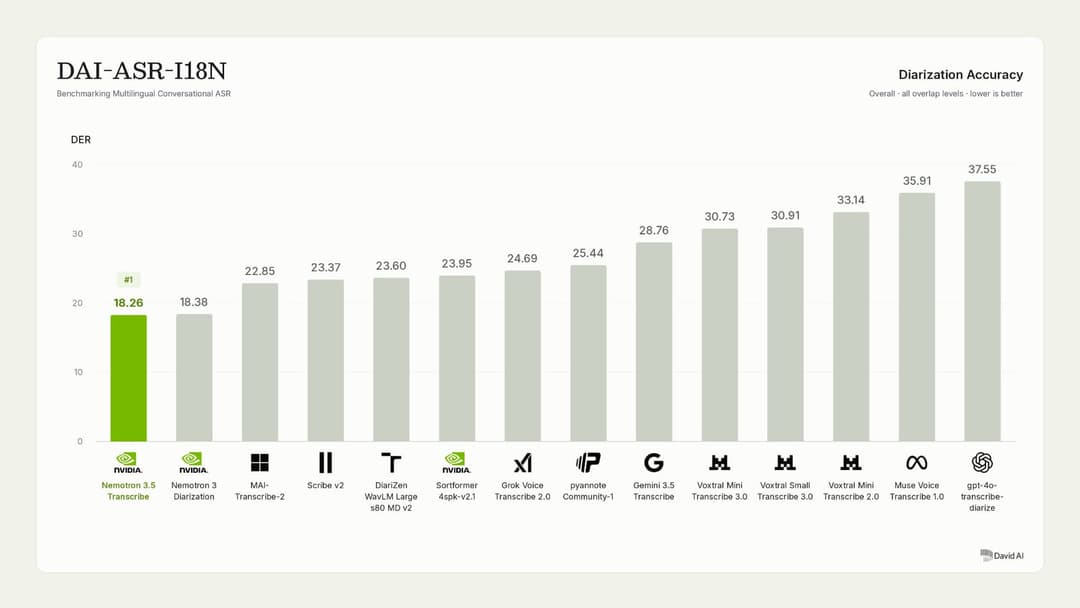
Пропущенных слов у модели 8,32% при медиане около 31% по всем системам. А в тесте David AI на 21 языке ошибка разделения спикеров у неё 18,26%, у Nemotron 3 Diarization 18,38%, у gpt-4o-transcribe-diarize 37,55%. Специализированную модель самой Nvidia обогнали совсем немного, но обогнали.
Датасет Granary v2
Вместе с моделью вышла вторая версия открытого корпуса Granary: около 844 тыс. часов речи на 48 языках. В первой было около 643 тыс. часов на 25 языках. Каждая запись есть в двух стилях расшифровки. Дословный сохраняет «э-э» и записывает числа словами. Очищенный убирает паразитов и ставит цифры.
Nvidia выложила и инструменты, которыми собирала корпус, их можно запускать на собственных записях. Оговорка от компании: датасет не полностью совпадает с тем, на чём обучали саму модель. Ранее Granary уже использовали для мультимодальной Nemotron 3 Nano Omni.
Дообучение: пример с врачами
Лучше всего возможности модели показывает эксперимент на записях индийских врачей и студентов-медиков. Обучающие данные в основном синтетические.
| Этап | WER |
|---|---|
| Базовый промпт | 30,8% |
| Точный промпт | 23,8% |
| После дообучения | 11,8% |
На новых, ранее не слышанных спикерах ошибка упала с 22,44% до 12,17%, то есть на 45,8%. Дообученная версия обошла открытую медицинскую модель с результатом 13,79%. Весь процесс занял около 14 GPU-часов на одном GB300.
Цена такой специализации понятна: на общей английской речи ошибка немного выросла. Зато торговые названия лекарств модель распознаёт точнее. Nvidia советует отложить минимум 100 реальных проверенных записей для тестов, не доверяя синтетике. Для дообучения есть гайды и расширение, которое позволяет ИИ-ассистенту для написания кода запускать обучение.
Чего модель не умеет
Главное ограничение: только записи. Потоковой обработки нет, так что для живых эфиров и голосовых агентов нужны другие инструменты. Рядом как раз выходят Voxtral 3 от Mistral, ориентированный на агентов в реальном времени, и Realtime от ElevenLabs. Возможности зависят от языка, а ответы на вопросы по аудио обучались на английском. Имена, смену спикеров и ответы модели Nvidia советует проверять выборочно.
Модель и датасет лежат на Hugging Face (коллекция nemotron-speech и Granary-v2), демо работает в Spaces.
Что это меняет в работе
Для тех, кто монтирует интервью, подкасты и документалки, архив записей обычно мёртвый груз: слушать некогда, искать негде. Здесь один прогон даёт текст с разметкой голосов, перевод и ответ на вопрос вроде «в какой момент герой говорит о бюджете». И всё это на собственном железе, без отправки материала в чужое облако. Мы бы начали с самого неудобного архива и посмотрели, как модель справится с перебивающими друг друга людьми, на которых она и тестировалась.
Если верить цифрам, расшифровка перестала быть отдельной профессией и стала строчкой в промпте.