Cohere представила Parse — модель для разбора корпоративных документов
Документ со сложной вёрсткой — таблица со слитыми ячейками, скан договора с рукописной пометкой на полях, счёт-фактура с логотипом поверх текста — человек разбирает за секунды. Для корпоративного пайплайна это обычно провал: обычный OCR путает столбцы, теряет иерархию заголовков и не понимает, что диаграмма на странице — это диаграмма, а не текст. Cohere выпустила модель, которая обещает закрыть именно этот разрыв.
Parse — вижн-языковая модель, заточенная под разбор корпоративных документов: она превращает многостраничные файлы, таблицы и изображения в чистый структурированный markdown, пригодный для поиска, RAG-систем и агентных сценариев. В отличие от простого OCR, Parse распознаёт таблицы, формы, диаграммы и встроенные картинки, сохраняя структуру документа через координаты каждого визуального блока — это то, что в индустрии называют пространственной осведомлённостью, и именно она нужна, чтобы агент мог сослаться на конкретную ячейку таблицы, а не пересказать документ целиком.
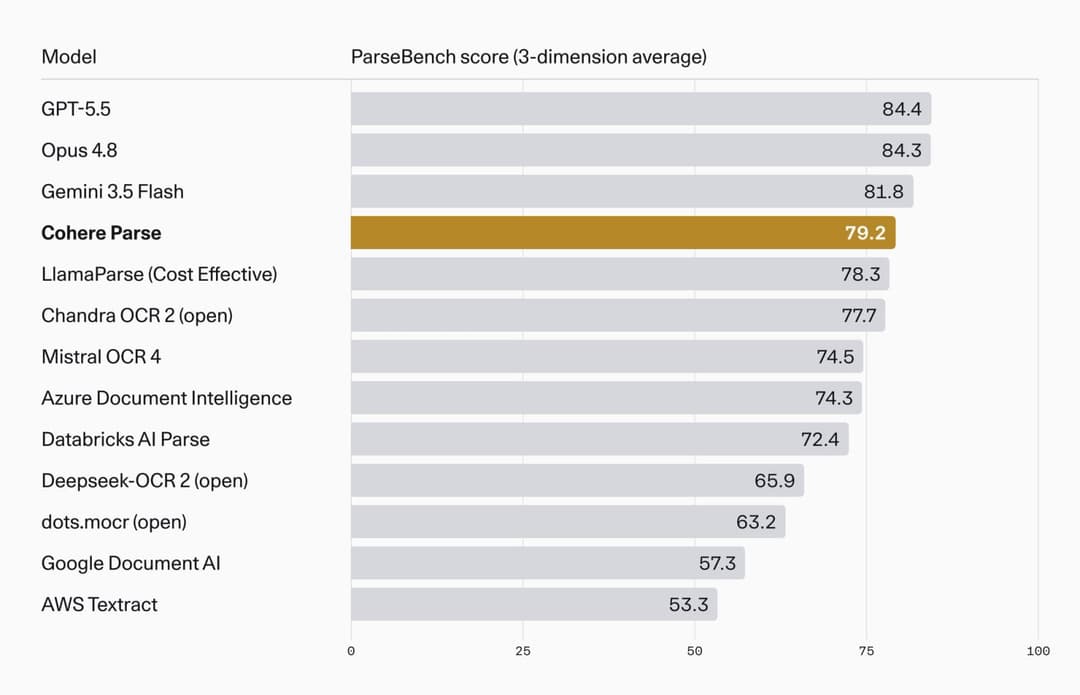
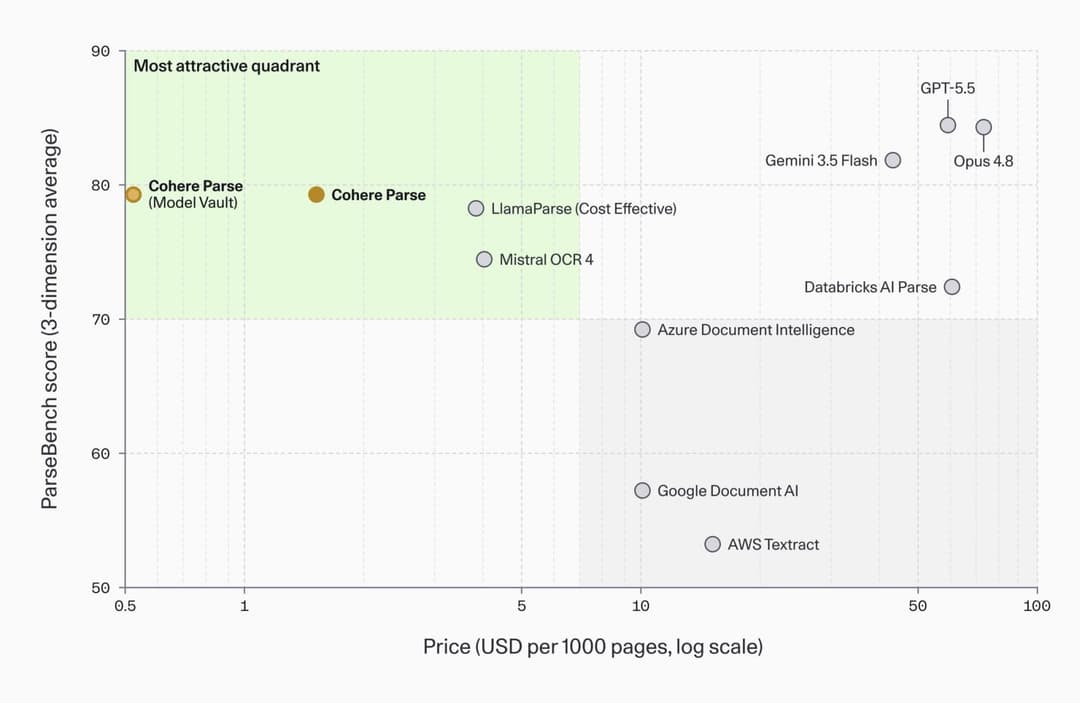
На собственном бенчмарке ParseBench, который меряет качество разбора по трём параметрам — точность таблиц, сохранение содержания и семантическое форматирование, — Parse набрала 79,2 балла. Это выше, чем у Mistral OCR 4 (74,5), Databricks AI Parse (72,4) и заметно выше показателей Google Document AI (57,3) и AWS Textract (53,3). Обойти Parse смогли только универсальные флагманские модели — GPT-5.5, Opus 4.8 и Gemini 3.5 Flash, — но они и крупнее, и ощутимо дороже в пересчёте на страницу.
Экономика важнее бенчмарков
Именно в цене — главный аргумент Cohere. Доступ через обычный API стоит полтора доллара за тысячу страниц. Для тех, кто разбирает документы постоянно и в больших объёмах, компания предлагает Model Vault — выделенную инфраструктуру, которая при половинной загрузке GPU снижает стоимость на 23%, а при полной — на 61%. Cohere приводит расчёт: компания, обрабатывающая 13 миллионов страниц счетов и накладных в месяц, сэкономит на Model Vault около 12 тысяч долларов ежемесячно — 144 тысячи в год. По сравнению с типичным облачным сервисом по 10 долларов за тысячу страниц, экономия для такого объёма дорастает почти до полутора миллионов долларов в год.
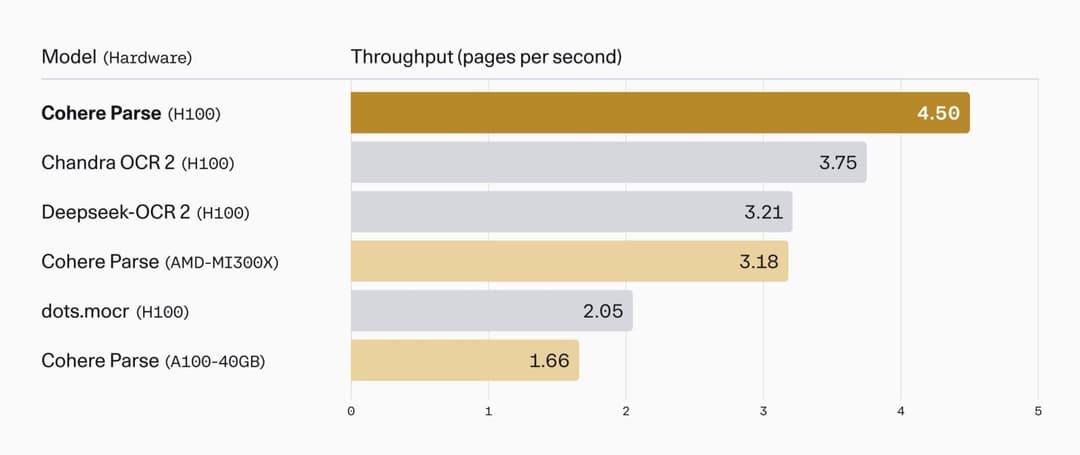
Производительность тоже в фокусе: на связке из восьми видеокарт H100 модель обрабатывает до 2160 страниц в минуту — в полтора раза быстрее открытой dots.mocr и больше чем вдвое быстрее Chandra OCR 2 при одинаковом железе.
Parse поддерживает девять основных языков мира и уже доступна через API Cohere, платформу Model Vault, Microsoft Foundry и AWS SageMaker. Модель также встроена в поисковый стек Compass — вместе с Embed и Rerank, — так что компании могут собрать полный пайплайн от разбора документа до готового ответа, не склеивая инструменты вручную. Для регулируемых индустрий доступно развёртывание в приватном облаке или на собственном железе — то самое требование, из-за которого банки и страховые годами опасались отдавать документы в облачный ИИ.
Рынок разбора документов долго жил в тени более ярких генеративных историй про картинки и видео. Cohere делает ставку на то, что тысячи скучных PDF с накладными и договорами — не менее выгодный бизнес, чем эффектная генерация, просто про него обычно не пишут громких заголовков.