Canva Craft учится на реальных макетах вместо фотографий
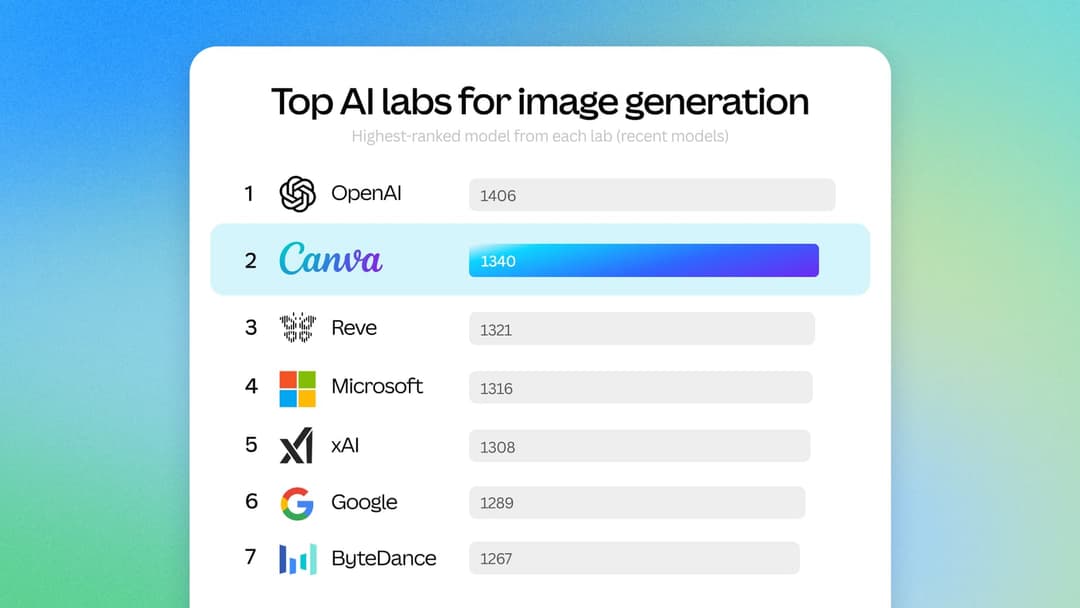
Попробуйте попросить популярную диффузионную сетку собрать аккуратный флаер для кофейни. На выходе почти наверняка окажется безупречно прорисованный стаканчик латте, поверх которого размазана имитация латиницы, а заголовок упрямо налезет на ключевой объект. Нейросети последних лет великолепно копируют свет, оптику и фактуру кожи просто потому, что их бесконечно кормили фотографиями. Команда Canva решила подойти к генерации с другой стороны и выкатила Canva Craft — собственную модель, которую учили не на стоковых кадрах, а на реальной дизайнерской верстке.
За спиной у сервиса солидная база: инструментами платформы сегодня пользуются 95% компаний из списка Fortune 500. Собственная исследовательская группа Canva разрабатывала модель как прямого конкурента решениям от Google, OpenAI, ByteDance и Meta. Но если технологические гиганты скармливают алгоритмам терабайты сырых фотоснимков, то в обучающий датасет Craft легли миллионы готовых человеческих макетов из внутренней библиотеки платформы.
Макет вместо фотопленки
Модель тренировали понимать, как живой специалист выстраивает плоскость листа или экрана. В обучающую выборку вошли сугубо прикладные форматы:
- постеры и рекламные афиши;
- оформление публикаций для социальных сетей;
- слайды презентаций;
- инфографика со сложной структурой данных;
- ресторанные и барные меню;
- макеты с высокой плотностью текста.
Смысл такого подхода в том, чтобы передать алгоритму базовые правила визуальной культуры. Представители Canva формулируют логику просто: «В отличие от плоских картинок, шаблоны учат модель тому, как именно сочетаются верстка, визуальная иерархия и типографика». Когда система видит меню или плакат, она запоминает не просто пиксели, а логические связи: заголовок должен считываться первым, плашка не должна спорить с иллюстрацией, а строкам нужен воздух.
Два шага до чистовика
Сам пайплайн генерации в Canva Craft инженеры разделили на два независимых этапа. Сначала модель берет текстовый запрос и работает как арт-директор: продумывает структуру, распределяет визуальный вес, определяет габариты объектов и намечает координаты текстовых блоков. Только после того, как черновая композиция утверждена на внутреннем уровне, запускается второй этап — финальный рендеринг.
На выходе инструмент отдает результат в разрешении до 2K. При этом модель изначально заточена под реальное производство контента: в ней заложено больше 30 вариантов соотношений сторон под разные платформы и задачи, от сторис до широкоформатной наружки. Архитектура ориентирована на создание реалистичных сцен, цифровых иллюстраций и рекламной графики, где встроенные надписи остаются разборчивыми, а не превращаются в кашу из глифов.
Для арт-директора и дизайнера здесь любопытнее всего точечный контроль. Двухэтапная сборка позволяет редактировать конкретные куски генерации прямо внутри макета: можно заменить один неудачный объект или переписать текстовый слой, не перерисовывая фон и не ломая всю сцену целиком.
Нас в этой истории подкупает прагматичный сдвиг фокуса. Вместо бесконечной гонки за гиперреализмом зрачков и шерстинок разработчики попытались научить машину базовой дизайнерской гигиене. Когда нейросеть с первого промпта понимает, где оставить воздух под логотип и как не перекрыть плашкой лицо героя, рутинная сборка макетов наконец-то перестает быть борьбой с генеративным хаосом.