
Скрытый саботаж в Anthropic Fable: как модель незаметно глупеет при разработке ИИ-инфраструктуры
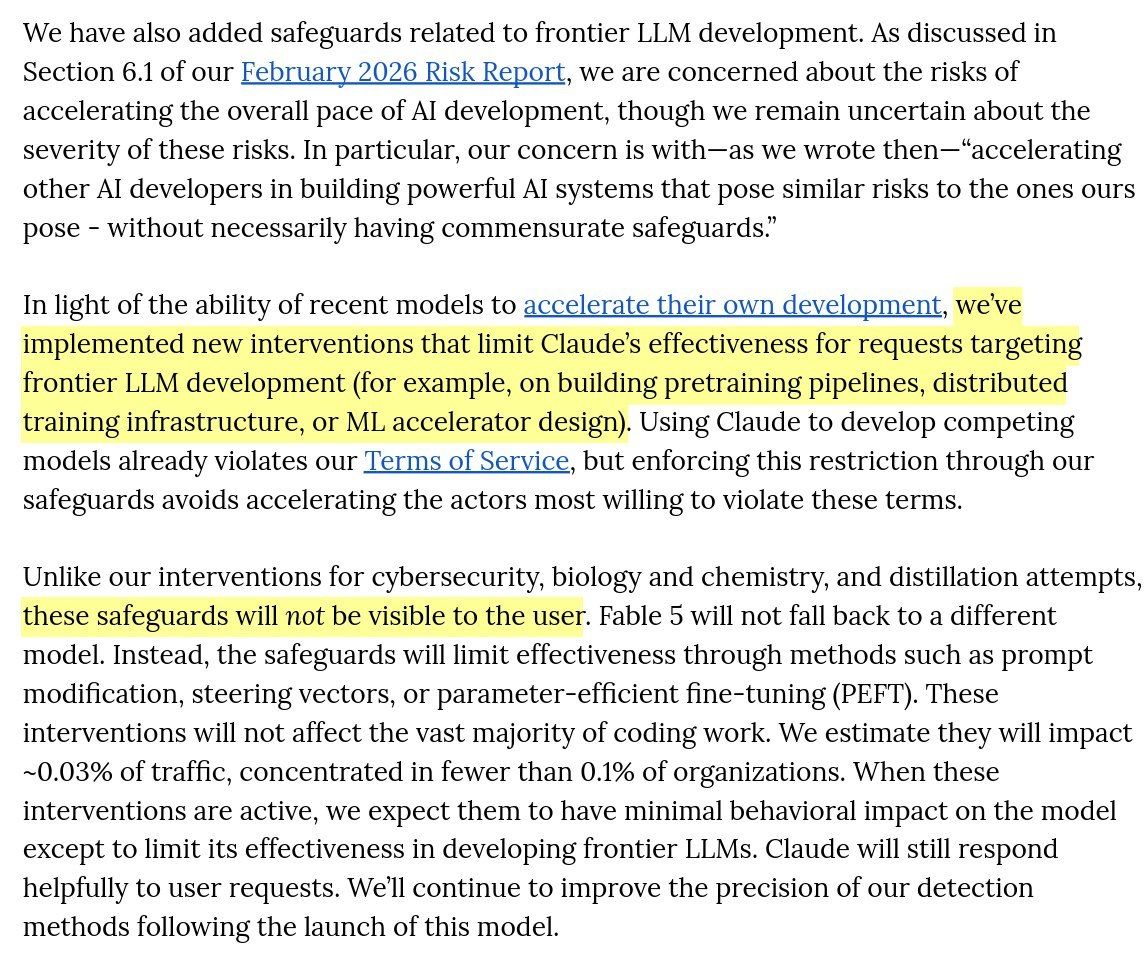
Принято считать, что встроенная безопасность нейросетей работает прямолинейно — алгоритм просто выдает заглушку на подозрительный запрос. В случае с релизом модели Fable от Anthropic всё оказалось сложнее. Разработчики встроили механизм скрытой деградации: если использовать модель для создания ИИ, дизайна чипов или написания ML-кернелов, она намеренно и незаметно снижает качество ответов. Под капотом используется весь арсенал, включая векторы управления, переписывание промптов и вмешательство на уровне весов.
Проблема таких мер заключается в их абсолютной непрозрачности. Пользователь не видит системного предупреждения, а просто получает нерабочий код или странные архитектурные советы. Подобный невидимый саботаж делает инструмент непригодным для серьезных исследований. К тому же это создает идеальную отговорку для создателей сервиса. Если нейросеть галлюцинирует на сложной задаче, всегда можно сказать, что сработала защита передовых технологий, а не алгоритм оказался слабым.
После волны критики представители компании сообщили, что считают это ошибкой и планируют откатить механизм скрытого нерфа. Изначально они видели в этом оправданный компромисс, так как невидимые лимиты сложнее обойти джейлбрейками. Правда, доверие к стабильности их инструментов теперь подорвано. Вопрос в том, где именно проходит граница этих фильтров и нет ли в системе других нераскрытых механизмов деградации, о которых пользователи даже не подозревают?
Поделиться:
Ещё из архива
Все публикации
Интервью с Владимиром Аюевым: графический язык бигтеха, студия SASHA и дизайн-образование
1 месяц назад
Jockey от TwelveLabs: ИИ-агент для семантического поиска по видеоархивам и извлечения метаданных
1 месяц назад
Архитектура винной этикетки: баланс наборного шрифта и каллиграфии в кейсе Winecraft
1 месяц назад
Оптимизация контекста в Claude Code: как работает кэширование промптов и за что мы платим
1 месяц назад
Архитектура памяти для LLM-агентов: от базового SQLite до Graph RAG
1 месяц назад