Tencent открыла модель интерактивных видеомиров Hy-Nomas
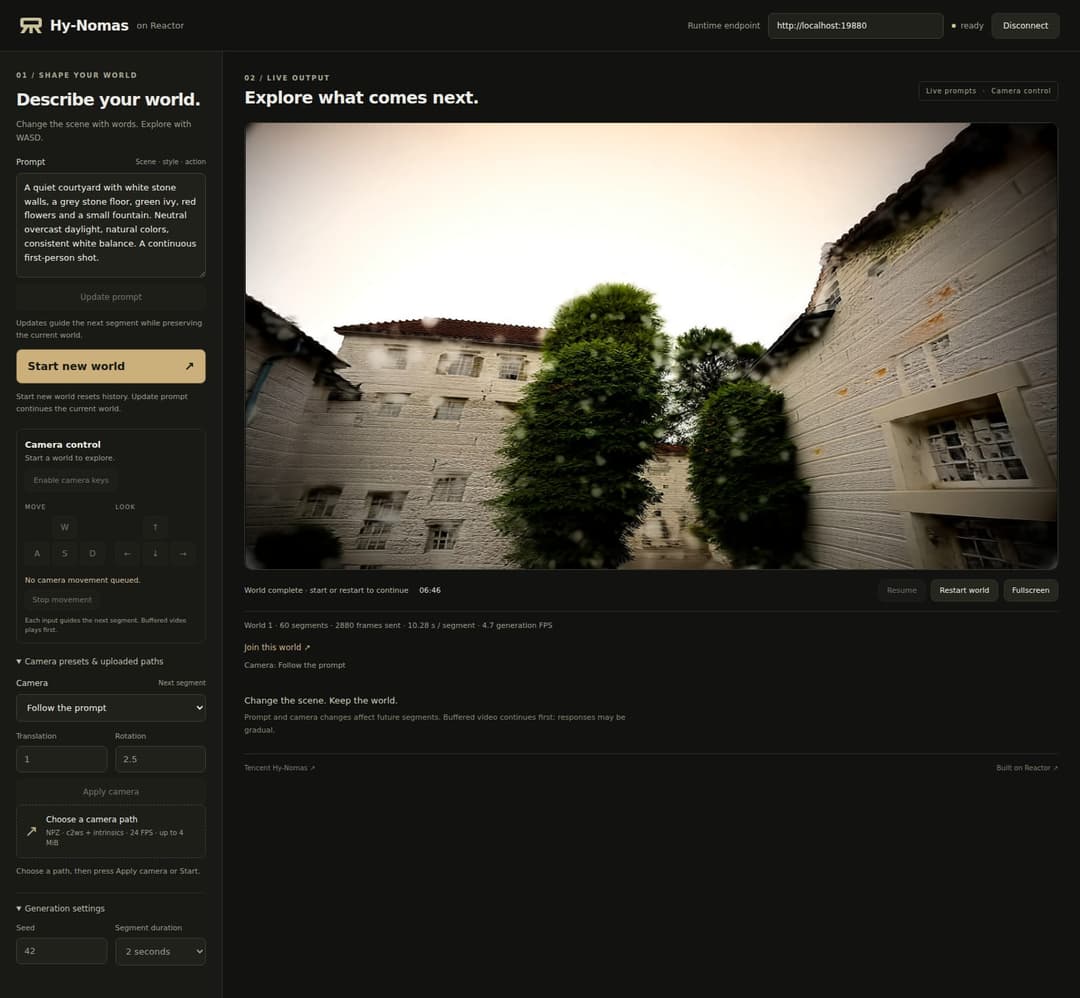
Клавиша W двигает объектив вперёд сквозь неоновый переулок, D уводит ракурс вбок, а в поле ввода прямо во время пролёта впечатывается смена погоды — и следующий пятисекундный отрезок подхватывает мокрый асфальт без сброса геометрии. Tencent Hunyuan выложила в открытый доступ Hy-Nomas. Код и веса архитектуры для интерактивной генерации видеомиров вышли под свободной лицензией Apache 2.0: здесь есть и репозиторий на GitHub, и веса на Hugging Face, и препринт arXiv 2610.36729. Для индустрии, привыкшей к закрытым демкам и очередям на закрытые тесты, жест непривычно щедрый.
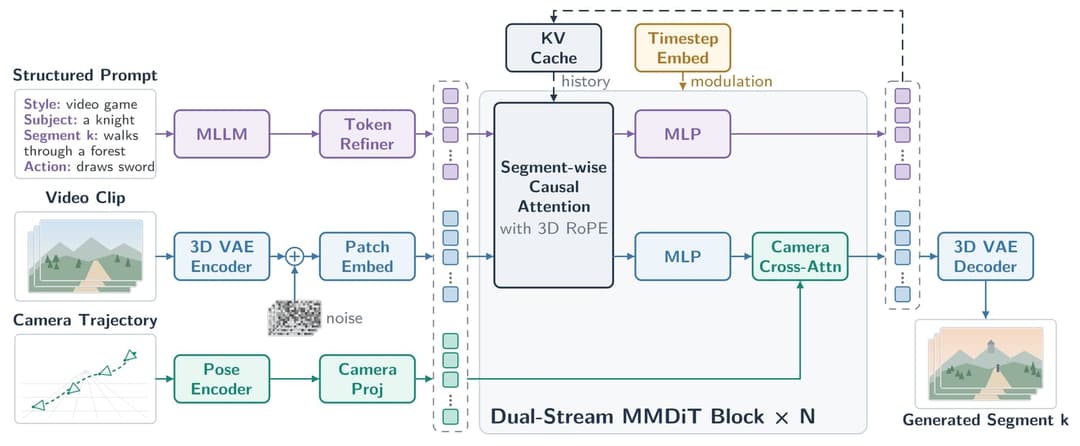
В отличие от привычных генераторов, выдающих глухой изолированный шот, Hy-Nomas работает по принципу непрерывного мира. Пространство собирается последовательными сегментами с помощью сегментно-авторегрессионного диффузионного трансформера (DiT). Ключевой элемент системы — долгоживущий персистентный KV-кэш: визуальный контекст переносится между кусками, удерживая расстановку объектов и логику освещения. Текстовое описание можно переписывать на лету. Каждое изменение перекодирует условия только для будущего куска, а визуальная память, сид и контекст декодирования продолжают жить. Нас подкупило, что в сгенерированную сцену разрешают на ходу вводить новых персонажей, менять стилистику и задавать действия без перерендера с нуля.
Внутри трансформера находятся 54 блока типа double-stream со скрытым размером 2048, 16 головами внимания и позиционным кодированием 3D RoPE. В качестве текстового энкодера инженеры применили языковую часть мультимодальной Qwen2.5-VL-7B-Instruct. Её скрытые состояния на 3584 измерения сжимаются двумя слоями token refiner и проецируются в пространство DiT. Пространственно-временное сжатие обеспечивает видеоавтоэнкодер DCAE-V с 32 каналами latents, уменьшающий картинку в 32 раза по пространству и в 4 раза по времени. За финальную картинку отвечает отдельный дообученный 36-слойный декодер PixelUMM: он за один проход восстанавливает RGB-кадры тайлами 4×16×16, обрабатывая окна по 10 латентных кадров с пятикратным перекрытием.
Управление камерой и железо
Движение виртуального оператора подаётся напрямую в double-stream блоки через механизм extrinsics-внимания. Матрицы 4×4 группируются по четыре кадра, раскладываются во входной вектор и связываются с видеотокенами. Траекторию можно скормить заранее откалиброванным файлом NPZ (с массивами c2ws и intrinsics в правосторонней системе координат OpenCV), а можно вести вручную клавишами WASD и стрелками. Базовая скорость перемещения составляет 2,8 единицы в секунду, вращения — 25 градусов в секунду, с возможностью выставить готовые пресеты вроде фиксации взгляда или следования за промптом.
Для запуска авторы подготовили несколько официальных конфигураций, распределив аппетиты модели по разным классам ускорителей:
| Конфигурация | Число шагов | Целевое железо | Особенности работы с памятью |
|---|---|---|---|
| Стандартная (hy_nomas.yaml) | 8 шагов | 8× NVIDIA B200 / кластер | Полная история, BF16, без сброса на CPU |
| Быстрая (hy_nomas_fast.yaml) | 4 шага | Мульти-GPU | Окно истории в 36 латентных кадров, риск дрейфа |
| Однопроцессорная low-mem | 4–8 шагов | 1× NVIDIA RTX 4090 | Веса DiT и KV-кэш в INT8, FP8-декодер, CPU offload |
В связке с рантаймом Reactor Runtime кластер из восьми карт NVIDIA B200 выдаёт в среднем 19,28 FPS на сегментах по 120 кадров при запросе 720×1280 (фактический вывод составляет 704×1280 RGB). Лимит непрерывного сеанса для одного мира ограничен 2880 кадрами — это ровно две минуты хронометража при 24 кадрах в секунду. Запустить модель на потребительской GeForce RTX 4090 с 24 ГБ памяти позволяет связка квантизованного INT8 DiT, декодера PixelUMM в FP8, урезанной до 18 латентных кадров истории и поочерёдной выгрузки модулей в оперативную память через FlexAttention и CUTLASS. Правда, авторы честно предупреждают: в Reactor запуск на 4090 пока не валидирован, а квантованный загрузчик не умеет подхватывать адаптеры на лету.
Набор ассетов репозитория закрывает сразу несколько сценариев. Базовый недистиллированный DiT предназначен для обучения собственных адаптеров методом LoRA на пользовательских видео. Для быстрой генерации за 4–8 шагов выложен дистиллированный чекпоинт, с которым можно бесшовно объединять готовые веса. В поставку вошли Cinematic LoRA для киношной фактуры и Robotics LoRA, натренированная на базе манипуляторов RealSource-World для симуляции робототехники. В комплекте идёт и модель Nomas-PE, которая на лету разворачивает короткие реплики пользователя в структурированные промпты для веб-интерфейса.
Экосистема вокруг релиза разрослась буквально за неделю с момента публикации первых исходников 21 октября 2026 года. Сообщество оперативно встроило модель в WanGP v18.81, SGLang, ComfyUI и создало демо для Google TPU v6e-4, где генерация 720p шла без опозданий кадров. Сами разработчики выкатили бенчмарк Hy-Nomas-Bench из 280 тестов на пространственную память и управляемость, а также показали сравнение с Genie 4, повторив чужие сцены на своей открытой архитектуре. В галерее авторов собрано 74 ролика: от бродилок с видом от первого лица, экскаваторов и разлива латте-арта до Тони Старка в мастерской и Вито Корлеоне у окна кабинета.
Для арт-директора и моушн-дизайнера Hy-Nomas интересна не сухими цифрами латентов, а сменой самого пайплайна. Вместо слепой генерации десятков случайных дублей в надежде поймать удачный ракурс мы получаем управляемую виртуальную съёмочную площадку, где можно выставить свет текстом, пролететь камерой по точным координатам и дописать нужный реквизит в уже существующий кадр.
Режиссура в нейросетях наконец-то перестаёт быть лотереей с перебором случайных чисел.