Самообучение нейросетей ускорилось: Джек Кларк сдвинул прогноз автономности на год
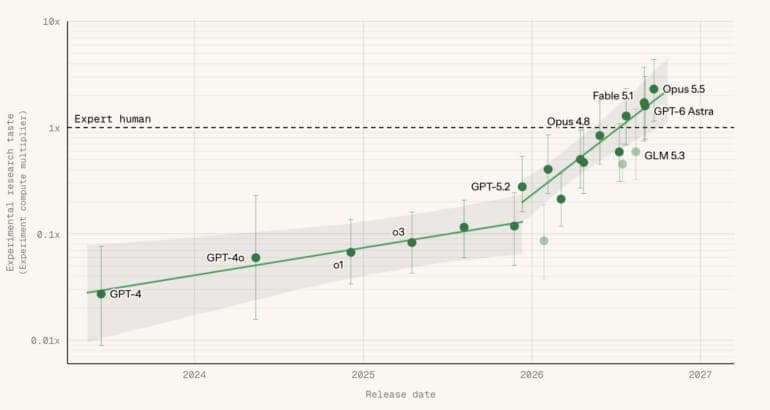
Сорок часов машинного времени на единственном ускорителе Nvidia H100 — ровно столько отмерили алгоритмам, чтобы выяснить, умеют ли они ставить эксперименты лучше собственных создателей. Сооснователь Anthropic и автор бюллетеня Import AI Джек Кларк посмотрел на свежие метрики этого теста и официально перенес собственный прогноз. Момент, когда системы искусственного интеллекта перейдут к полноценному рекурсивному самосовершенствованию (RSI) — то есть начнут стабильно проектировать и обучать более мощные версии самих себя, — теперь ожидается не в 2028 году, а уже в 2027-м.
Еще в мае расклад выглядел куда спокойнее: Кларк оценивал шансы увидеть независимую разработку следующего поколения моделей к концу 2028 года в 60%, а на 2027 год оставлял лишь скромные 30%. Однако прогресс в математических расчетах и запуск бенчмарка TasteVal от исследовательской группы P-Zero Research заставили переписать таймлайн. Тест взялся оцифровать категорию, которую в лабораториях Кремниевой долины долго считали сугубо человеческой привилегией — так называемый «исследовательский вкус».
Как измерить инженерную интуицию
Авторы бенчмарка разложили исследовательский вкус на три базовые компетенции: умение находить перспективные гипотезы, проектировать чистые эксперименты и безошибочно трактовать полученные графики. Первую часть оставили за скобками — TasteVal сфокусировался на проверке двух прикладных навыков. Моделям предложили восемь уровней задач с фиксированными целями и строгой системой баллов, охватывающими полный цикл разработки:
- фильтрацию и отбор массивов данных для обучения;
- базовый претренинг и последующий файнтюнинг языковых моделей;
- настройку обучения на основе человеческих предпочтений (RLHF);
- выстраивание защиты от состязательных промптов.
Чтобы исключить из уравнения банальное умение быстро писать скрипты, инженеры исключили разницу в кодинге: все эксперименты запускал стандартизированный агент-помощник. Каждой модели выделили жесткий лимит — не более 40 GPU-часов или 120 астрономических часов работы на графическом процессоре Nvidia H100. Эталоном стали результаты 24 живых специалистов, имевших за плечами опыт работы в OpenAI, Google DeepMind, Nvidia и Microsoft Research. Каждую задачу параллельно решали как минимум двое таких исследователей.
Вычислительный мультипликатор и фактор цены
Главной валютой тестирования стала вычислительная эффективность — показатель compute multiplier. Поскольку доступ к мощным серверным стойкам остается дефицитным и дорогим ресурсом, способность модели отказаться от заведомо тупиковых тестов экономит гигантские бюджеты. Интеллект оценивали по тому, сколько вычислений потребовалось алгоритму, чтобы добраться до планки, заданной живыми специалистами.
| Параметр тестирования | Показатель моделей | Человеческий эталон |
|---|---|---|
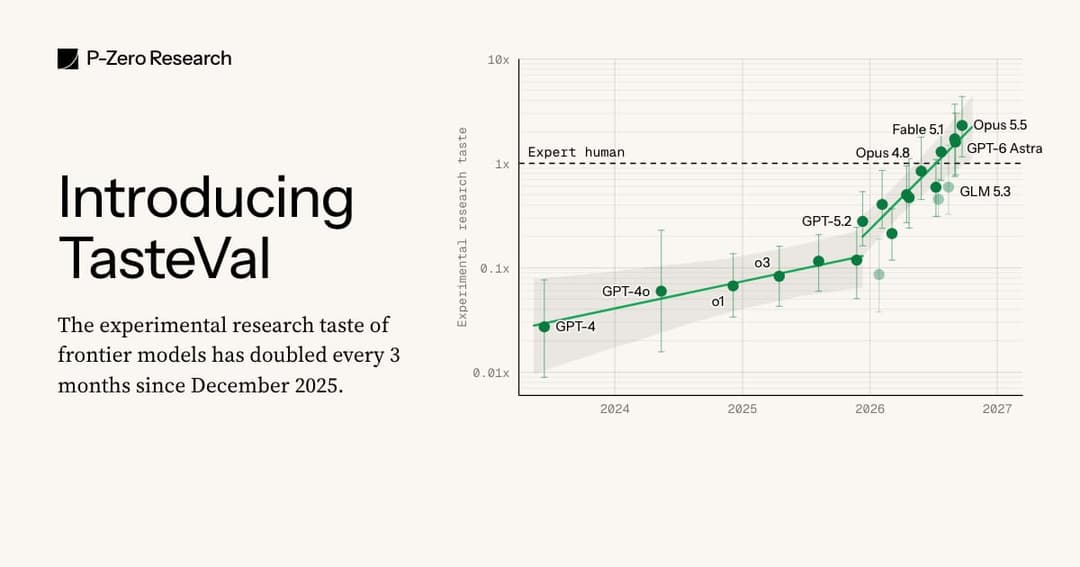
| Лидер бенчмарка (Opus 5.5 от Anthropic) | Коэффициент compute multiplier 2.3 | Базовый уровень 1.0 |
| Статистический разброс эффективности | От 1.15 до 4.37 | Фиксированная норма специалистов |
| Затраты на одну попытку решения | ~1/30 от стоимости экспертной сессии | Полный бюджет найма и инфраструктуры |
| Лимит на выполнение серии задач | 40 GPU-часов (до 120 астрономических) | 40 GPU-часов на Nvidia H100 |
Результат флагманской модели Opus 5.5 от Anthropic показал, что сеть способна повторить выводы опытных инженеров, потратив меньше половины от их объема вычислительной мощности. При этом одна итерация обходится лаборатории примерно в тридцать раз дешевле, чем рабочее время человека аналогичной квалификации. По подсчетам P-Zero Research, начиная с декабря 2025 года исследовательская хватка топовых моделей удваивается каждые три месяца (с погрешностью от 1.7 до 5.0 месяцев). До этой точки график рос плавно и почти незаметно.
Слепые зоны автономного кода
Впрочем, индустрия пока не спешит отдавать ключи от дата-центров скриптам. Создатели TasteVal честно признают слабости методики: короткие и относительно дешевые тестовые задачи легко превратить в мишень для целевой оптимизации, а в контрольную группу людей не вошли главные архитекторы индустрии. Независимые исследователи вроде Херби Брэдли резонно замечают, что нейросети отлично справляются с рутиной младших научных сотрудников, но долгосрочное планирование и подлинно нестандартные ходы им все еще не даются.
Цифры академических замеров это подтверждают. Совместная работа команды Фуданьского университета по исследованию агентных систем показала любопытный дисбаланс: ИИ-агенты сегодня генерируют до 55% рабочих методологических предложений, однако более 85% финальных архитектурных решений по-прежнему принимают живые кураторы. Понимая скорость сжатия сроков, главы лабораторий заговорили о тормозах. Руководитель Anthropic Дарио Амдеи открыто настаивает на введении временных лимитов и жесткого регламента для самосовершенствующихся систем, а в OpenAI повторяют, что до полной автономности еще далеко и человек обязан удерживать контроль над каждым циклом обновлений.
Для креативного продакшена и арт-директоров этот сдвиг дат означает простую вещь: окно между выходом сырого инструмента и его безупречной версией схлопывается на глазах. Если раньше мы ждали годами, пока разработчики вручную допилят генерацию консистентных кадров, физику ткани или честный свет, то теперь оптимизацией этих пайплайнов займутся сами модели внутри закрытых контуров. Скорость обновления софта перестает упираться в размер штата программистов — она упирается только в доступный объем чипов.
Похоже, профессия постановщика задач окончательно вытесняет профессию исполнителя даже внутри самих лабораторий разработки.