Odyssey-3 симулирует законы физики для генеративного продакшена
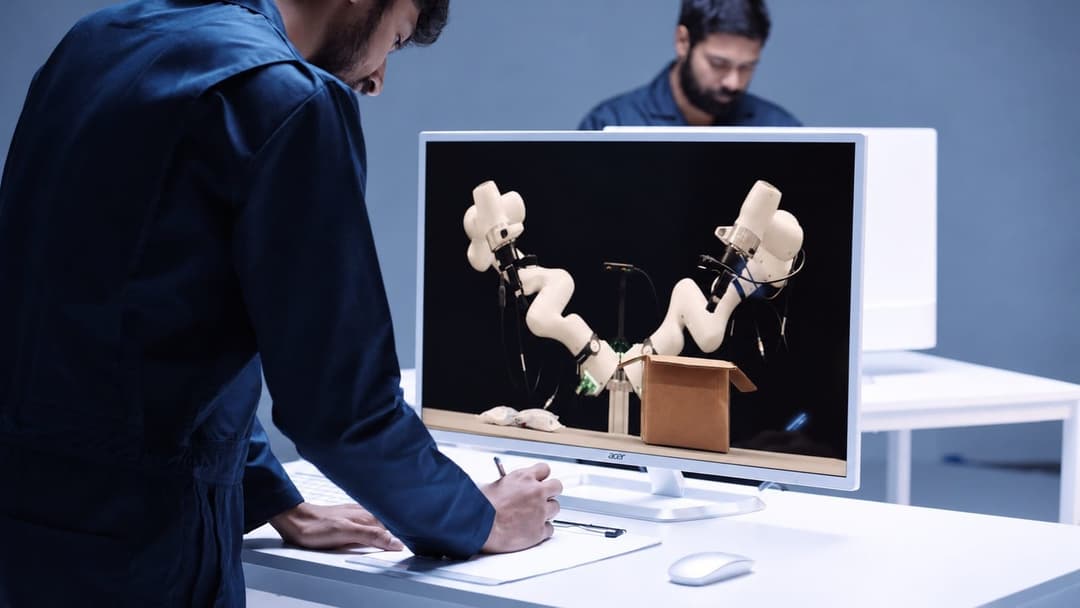
Каждый, кто хоть раз пытался сгенерировать в диффузионных сетях опрокидывающийся стакан с водой или отскакивающий от асфальта мяч, знает этот специфический кошмар: стекло плавится, жидкость испаряется в воздухе, а гравитация внезапно меняет направление. До сих пор генеративные модели просто подбирали похожие пиксели из обучающей выборки, абсолютно не понимая, как устроена механика твердого тела или почему тяжелый предмет падает быстрее перьевой подушки. Команда стартапа Odyssey подошла к проблеме с другой стороны и представила Odyssey-3 — фундаментальную модель мира, которая просчитывает поведение пространства во времени.
За проектом стоят инженеры, которые десять лет проектировали системы управления беспилотными автомобилями. Логика там ровно та же: беспилотник обязан предугадывать поведение пешеходов, траекторию попутных машин и сцепление колес с дорогой на несколько секунд вперед, иначе катастрофы не избежать. Перенеся этот багаж на генерацию визуала, разработчики построили авторегрессионный диффузионный трансформер, который не просто рисует картинку за картинкой, а симулирует динамическую систему.
Архитектура и гибридный датасет
Модель принимает текстовый запрос и выстраивает интерактивное окружение, в котором можно свободно управлять камерой. Предусмотрен вид от первого лица, вид от третьего лица, а также полностью независимая камера, позволяющая облететь сцену и проверить, насколько стабильно держится геометрия. Изменения сцены просчитываются на лету в ответ на действия пользователя или виртуального агента.
Чтобы научить нейросеть законам механики, инженеры собрали обучающую выборку из трех совершенно разных источников данных:
- Массив интернет-видео с точечно локализованными аннотациями каждого происходящего события;
- Игровой процесс с покадрово синхронизированными логами нажатий клавиатуры и перемещений мыши;
- Синтетические симуляции взаимодействия твердых тел, снабженные подробными физическими метаданными и подписями.
Каркас системы опирается на многоступенчатый видеодиффузионный трансформер, реагирующий на временные промпты и входящие команды. Чтобы тяжелая модель не рендерила один кадр часами, пост-тренировочный пайплайн объединил сопоставление распределений и состязательную дистилляцию. На выходе получилась быстрая сборка, готовая работать в интерактивном режиме реального времени.
Замеры физики и пространства
В стресс-тестах на симуляцию физических явлений старшая модификация Odyssey-3 Pro установила рекорд. В профильном бенчмарке Physics-IQ Verified для пайплайна «видео-к-видео» модель набрала 66.1 балла, забрав первое место среди всех существующих решений. В режиме «изображение-к-видео» показатель составил 54.7 балла. Этот тест проверяет предсказательную силу системы сразу в пяти базовых дисциплинах: гидродинамике, механике твердого тела, оптике, магнетизме и термодинамике.
В пространственном тесте WorldMark, который оценивает генерируемые миры по 13 критериям качества, Odyssey-3 также заняла лидирующие позиции почти во всех категориях.
| Категория WorldMark | Результат Odyssey-3 (баллы) | Позиция в бенчмарке |
|---|---|---|
| First-Person Stylized | 77.2 | 1 место |
| Third-Person Real | 79.0 | 1 место |
| Third-Person Stylized | 76.3 | 1 место |
| First-Person Real | 80.6 | 3 место |
Единственной категорией, где система уступила верхнюю строчку, осталась реалистичная навигация от первого лица, где модель заняла третье место.
От рендера к управлению роботами
Способность Odyssey-3 понимать физическую сцену оказалась настолько плотной, что ее начали использовать как мозг для физических манипуляторов. Адаптация под аппаратные платформы идет через дообучение специализированных декодеров действий на парах «наблюдение — действие». Модель успешно закрывает прикладные задачи для роборук, требуя для калибровки всего несколько десятков часов демонстрационных записей. Причем робот самостоятельно восстанавливается после ошибок: если захват сорвался, манипулятор переориентирует грейфер и повторно поднимает упавшую деталь.
В совместном эксперименте с компанией Flexion политики управления для гуманоидных роботов на базе Odyssey-3 обошли стандартные модели класса VLA (Vision-Language-Action). Нейросеть стабильно удерживала контроль над роботом даже в условиях хаотичной смены освещения и перестановки предметов в комнате. Для колесных платформ провели отдельный полевой тест на реальных индийских дорогах: бэкбон Odyssey-3 полностью заморозили, добавили всего 20 часов сырых данных вождения, и система начала уверенно предсказывать траекторию движения в замкнутом контуре. В тестах с мультисенсорными данными хватило 100 шагов дообучения, чтобы модель научилась синхронно генерировать три ракурса с разных камер беспилотника.
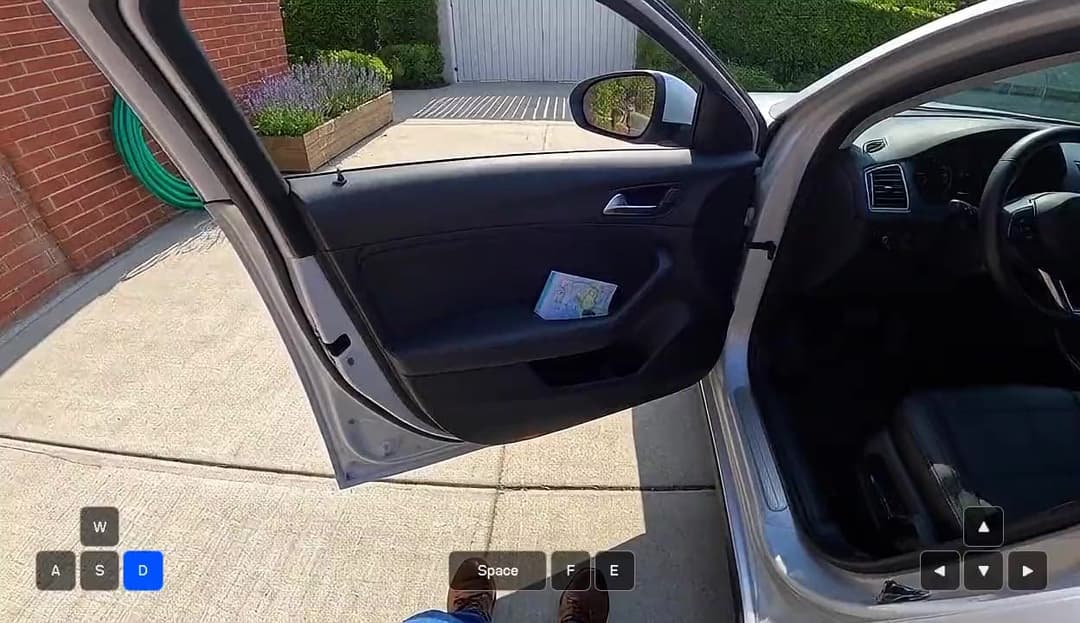
Сейчас разработчики открыли исследовательский превью-доступ к модели.
Для CG-индустрии, игровых дизайнеров и рекламного продакшена эта разработка знаменует тектонический сдвиг в сторону генерации, управляемой законами реального мира. До сих пор трехмерный пайплайн держался на незыблемом правиле: если тебе нужна точная физика тканей, столкновений и света, ты идешь в традиционные симуляторы или игровые движки, а генеративные нейросети оставляешь для мудбордов и концепт-арта. С появлением рабочих моделей мира грань начинает стираться: свет падает туда, куда должен, масса объекта ощущается в каждом кадре, а траектория камеры подчиняется пространственной логике. Похоже, следующий этап виртуального продакшена избавит нас от необходимости вручную склеивать распадающиеся законы физики на постпродакшене.