Ming-Image-0.1-Design берет на себя верстку плакатов и отдает честный прозрачный фон
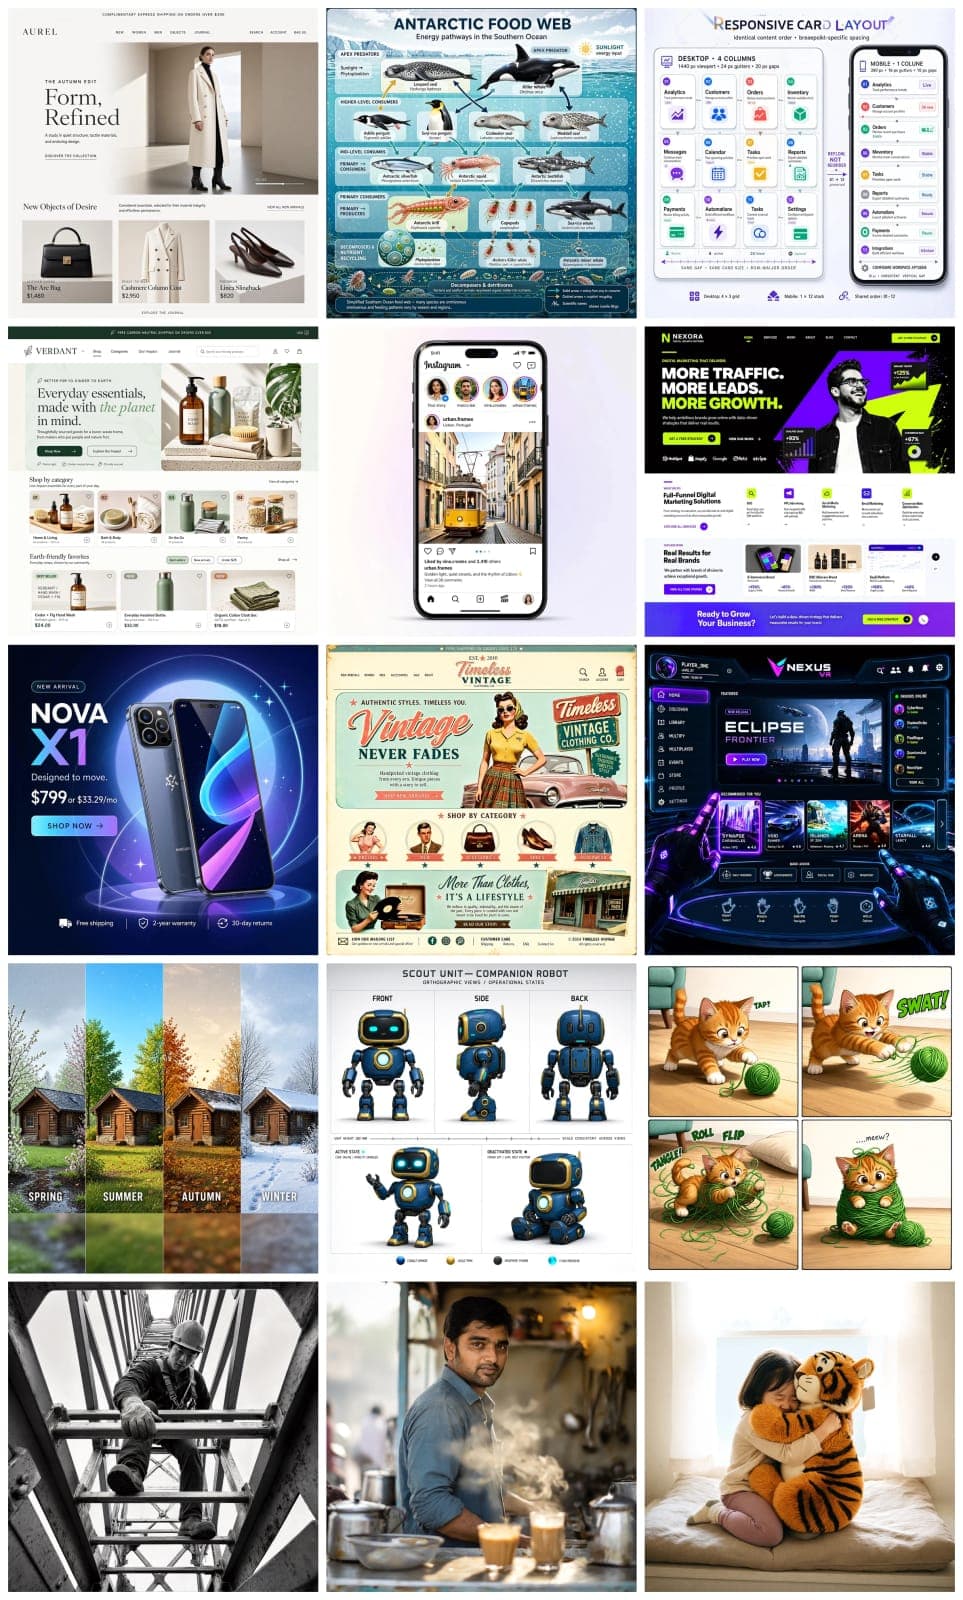
Самый дурацкий кошмар при выгрузке якобы прозрачной графики из генераторов — серо-белая шахматная клетка, намертво впеченная в пиксели растра. Добавьте к этому плывущие псевдобуквы вместо нормального набора, и сборка интерфейсных экранов или постеров превращается в ручную перерисовку с нуля. Разработчики выкатили Ming-Image-0.1-Design — открытую модель на 6 миллиардов параметров, которая целится ровно в эти две боли: плотную типографику и честный альфа-канал.
Архитектура специализируется на графических макетах с обилием текста, элементах пользовательских интерфейсов, инфографике и плакатах. Главное практическое свойство — прямая генерация файлов в формате RGBA. Модель отдает изображение с реальным прозрачным фоном, начисто игнорируя дурацкую привычку диффузионных сетей запекать в картинку узор фотошоповской сетки. Иконку, плашечный блок или текстовый слой можно сразу перетаскивать на рабочий артборд без возни с масками.
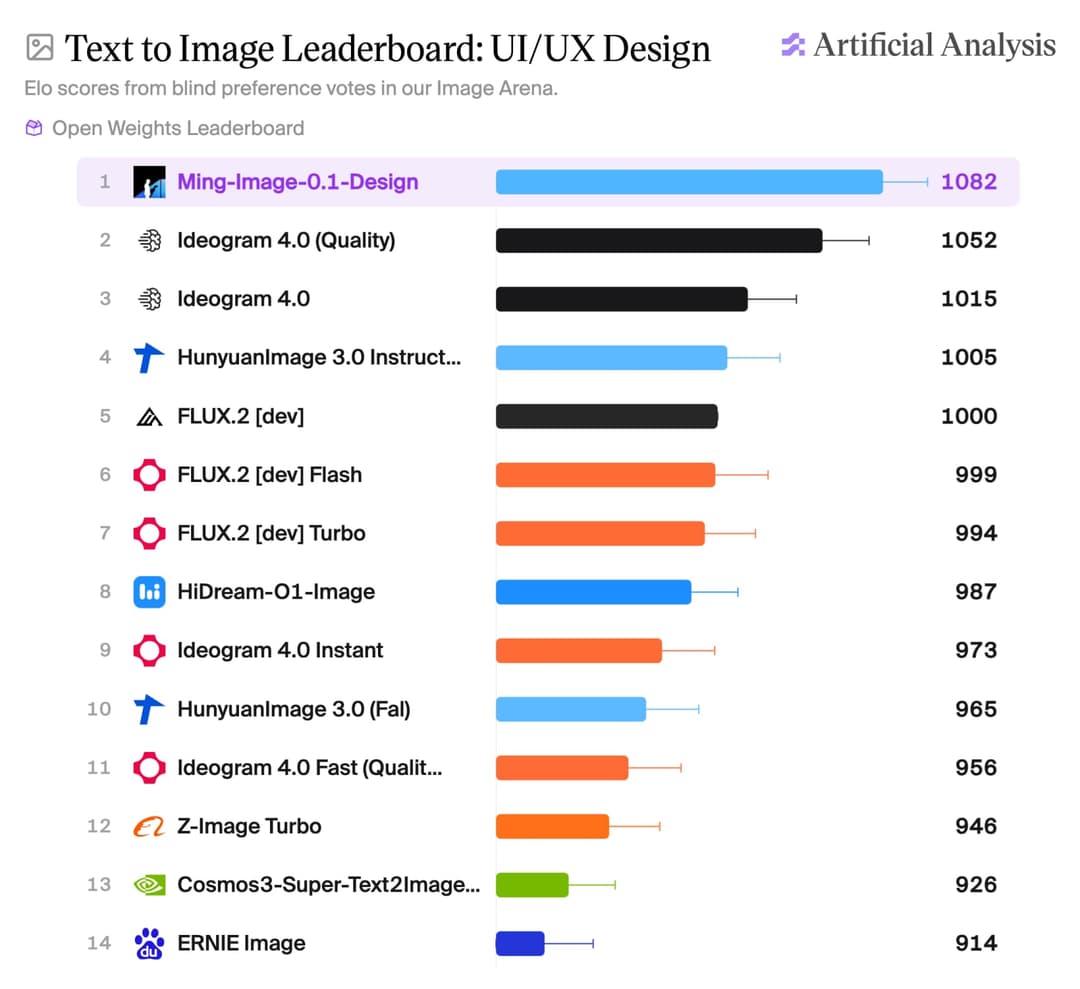
Параметры генерации и пайплайн
Для развертывания авторы советуют задействовать фреймворк vLLM-Omni. Сам код инференса, скрипты и инструкции по установке выложены в репозитории на GitHub под свободной лицензией MIT — редкая открытость для специализированного дизайн-инструмента.
Рекомендованные авторами настройки выглядят компактно:
- Базовое разрешение составляет 2048 на 2048 пикселей, а для ускоренной выдачи предусмотрен режим 1024 на 2048 пикселей.
- Количество шагов сэмплирования равно 12.
- Коэффициент шкалы классификатора (CFG) зафиксирован на значении 1.0.
- Вычисления проводятся с точностью BF16.
Чтобы выжать из верстки максимум и не формулировать пространные описания руками, в цепочку можно подключить вспомогательные модели. На этапе подготовки текстового промпта задействуются Ling-3.0-flash-VL или qwen3.8-27B — они докручивают формулировки и помогают точнее расставить визуальные акценты в кадре.
Локальный запуск на рабочей станции упрется в железо. Системные требования строгие: для инференса необходима конфигурация с одним графическим процессором CUDA, на борту которого установлено 80 гигабайт видеопамяти. Пожалуй, разворачивать среду придется на арендованном сервере, но скорость в 12 шагов этот порог отчасти компенсирует.
Нас подкупило, что проект решает сугубо прикладную задачу без претензий на абстрактную красивость. Когда генератор умеет удерживать типографическую структуру и сразу отдает прозрачный RGBA высокого разрешения, рутина сборки мокапов перестает быть наказанием.