Инструмент opus-sound-layer озвучивает моушн-графику через спектрограммы и Claude Opus
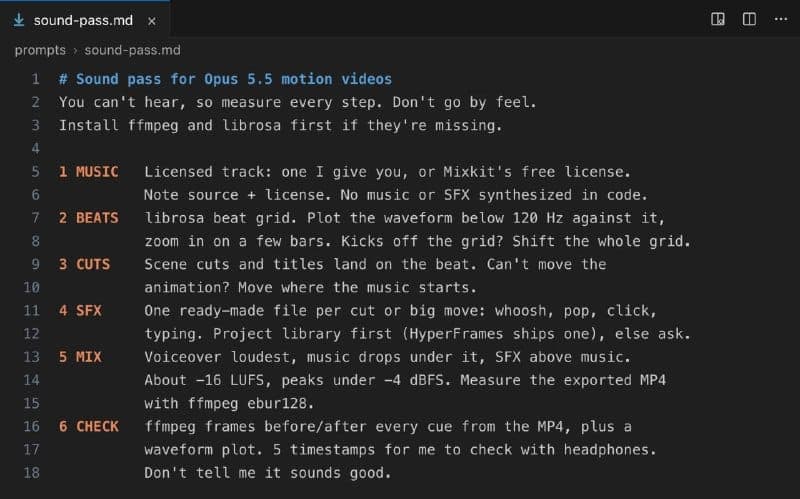
Пятнадцатисекундный ролик из Remotion или HyperFrames собран идеально, шейпы скользят по сетке, но на таймлайне царит гробовая тишина. Дальше начинается рутина, знакомая каждому моушн-дизайнеру: долгий отбор сотен коротких шорохов, щелчков и вздохов синтезатора на стоках, их ручная подгонка к каждому кадру и мучительное сведение дорожек, чтобы очередной свист интерфейса не перекрывал голос диктора. Генеративные модели до сих пор выдавали на этом этапе лишь мутную синтетическую кашу с плавающим таймингом. Разработчик проекта opus-sound-layer решил подойти к проблеме с инженерной прямотой: если языковая модель Claude Opus 5.5 физически не способна слышать звук, нужно показать ей аудиоряд глазами.
Система превращает звуковые дорожки в спектрограммы и графики форм волны, отдавая их нейросети в виде картинок. Модель анализирует визуальные маркеры движения в кадре, сопоставляет их с акустическими профилями реальных шумов и собирает полноценную партитуру без использования синтезаторов. В основу легли проверенные библиотеки семплов и строгие математические алгоритмы сведения.
Архитектура акустического слоя
В репозитории нет закрытых компонентов или громоздких нейросетевых надстроек. Проект опубликован под свободной лицензией MIT и опирается на связку утилит ffmpeg и пакетного менеджера uv, который сам разворачивает окружение Python и необходимые зависимости (а если корпоративный прокси капризничает с сертификатами, предусмотрен флаг UV_NATIVE_TLS=1). Сами аудиофайлы в кодовой базе не лежат — их на лету выкачивают скрипты.
Механика разделена на несколько автономных этапов:
- Сборка библиотеки (
scripts/sfx.py kit): модуль скачивает семь наборов сэмплов Kenney и вручную отобранные архивные записи с платформы Freesound. Скрипт режет исходники на чистые одиночные события, отсекает лишнее и генерирует каталогcatalog.jsonвместе с файлом атрибуцииCREDITS.md. Получается стартовый набор из 1 139 записей с лицензией CC0, распределенных по 19 конкретным категориям: hit, boom, riser, reverse, transition, whoosh, swish, glitch, ui, click, key, tick, tap, pop, thump, paper, chime, shimmer и zap. - Навигация и селекция (
scripts/sfx.py browse): ранжирует доступные звуки по тегам, длительности и спектральной яркости, формируя для модели шортлисты с графическими карточками волн. - Визуализация (
scripts/sfx.py sheet): генерирует визуальные отпечатки спектрограмм для каждого файла, позволяя большой языковой модели оценивать атаку и затухание шума по картинке. - Поиск недостающего (
scripts/sfx.py search/add): если стартового набора не хватает для специфической анимации, скрипт обращается к внешним базам либо принимает файлы со стороны, проверяет их характеристики и прописывает авторов в общую документацию.
Внешняя база и микширование по стандартам вещания
Когда локального набора из тысячи сэмплов оказывается мало, в дело вступает открытый интерфейс Openverse API. Нас подкупило, что интеграция работает полностью бесплатно и не требует регистрации персональных API-ключей. Платформа открывает доступ к каталогу из 5,2 миллиона свободных аудиофайлов, где собрано 590 тысяч звуковых эффектов и 640 тысяч музыкальных дорожек.
Работу с API разработчик жестко регламентировал системными промптами. Поскольку для анонимных подключений действует ограничение в 200 поисковых запросов за сутки, система отправляет запрос под каждый конкретный тип звука строго один раз. Поиск идет с обязательными фильтрами лицензий license=cc0,by,pdm по проверенным базам freesound и jamendo. Найденные файлы скачиваются локально через утилиту curl прямиком в директорию sfx/, а строчка с данными правообладателя без изменений переносится в итоговый текстовый отчет credits.txt.
Финальную сборку выполняет скрипт scripts/mix.py. Он берет сгенерированную моделью таблицу временных меток (cue sheet) и действует как опытный звукорежиссер: выравнивает пики по ключевым кадрам, раскладывает слои по типам и идентификаторам, накладывает акценты и корректирует громкость каждого события в его персональном частотном кармане относительно дикторского голоса и музыки. Скрипт умеет подтягивать питч эффектов под тональность фонового трека, помещает разрозненные сэмплы в общее акустическое пространство комнаты с помощью реверберации, применяет дакинг и делает резкие частотные срезы перед мощными ударами. На выходе получается сбалансированная звуковая дорожка с жестким стандартом громкости -14 LUFS и лимитером true-peak.
Перед отдачей готового MP4 запускается скрипт контроля качества scripts/qa.py. Программа с микроскопом проверяет совпадение пиков с видеорядом, точность тайминга, отсутствие клиппинга, читаемость каждого эффекта на фоне музыки и исключает случайные провалы в тишину. Малейшее отклонение от параметров — и процесс прерывается с системным кодом ошибки 1.
Пожалуй, именно такого подхода не хватало генеративным цепочкам в моушн-дизайне: вместо попыток заставить нейросеть выдумать звук с нуля, ей дали роль педантичного ассистента, вооруженного нормальным студийным софтом и каталогом чистых исходников. Рутинная расстановка сотен мелких звуков под интерфейсные анимации теперь сводится к одной команде в терминале.