ElevenLabs запустила модели Eleven Realtime для живого голосового диалога
Пауза в полсекунды — ровно столько человеку нужно, чтобы вдохнуть перед ответом собеседнику. Роботы в телефонных линиях и голосовые ассистенты обычно думают заметно дольше: пока звук превратится в текст, пока языковая модель соберет реплику, пока движок начитки ее озвучит. ElevenLabs решила разобрать этот слоеный пирог и представила семейство Eleven Realtime — сквозные speech-to-speech модели, где распознавание речи, мышление и синтез тембра сплавлены в единый непрерывный процесс.
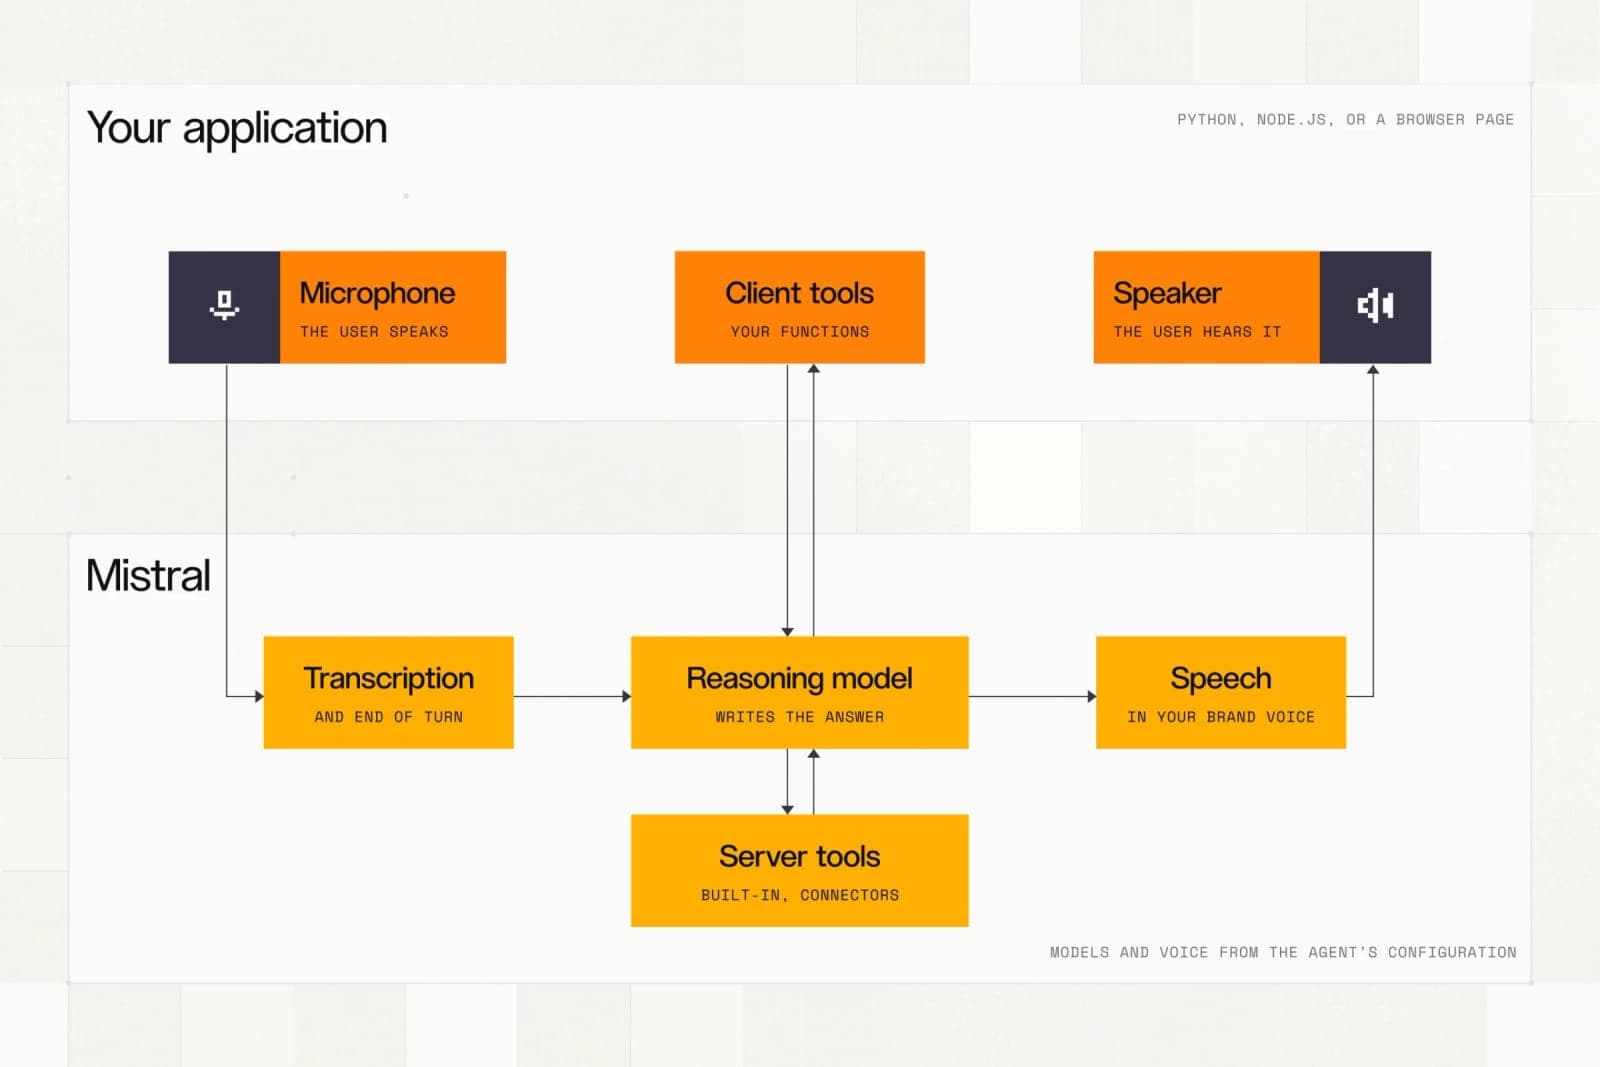
Суть архитектуры проста. До сих пор разработчикам интерактива приходилось связывать распознавание голоса, модуль отслеживания пауз, текстовую нейросеть и генератор звука вручную. Каждое звено добавляло задержку, превращая общение в сеанс связи с марсоходом. Линейка Eleven Realtime объединяет определение активности голоса, смену реплик, языковую модель и синтез речи в единую систему реального времени. Архитектура умеет слушать собеседника, вовремя замолкать на полуслове и даже выдавать естественные фоновые поддакивания.
Два калибра под разные задачи
В линейку вошли две модели с разным балансом вычислительной мощности и бюджета:
- Eleven Realtime v1 Mini оптимизирована для диалогов с низкой стоимостью. Ее создавали для ИИ-ассистентов, интерактивных персонажей и образовательных инструментов, где критична себестоимость каждого часа разговора.
- Eleven Realtime v1 Max рассчитана на тяжелые сценарии. Она создана для технической поддержки, квалификации лидов и многошаговой автоматизации, требующей глубоких логических рассуждений и обращения к сторонним сервисам.
Оба решения поддерживают свыше 90 языков и открывают доступ к библиотеке из более чем 17 000 голосов платформы.
Замеры скорости и сообразительности
Независимая площадка Artificial Analysis протестировала обе модели в трех направлениях: рассуждения, задержка отклика и динамика живого разговора. Результаты испытаний распределились следующим образом:
| Параметр и бенчмарк | Eleven Realtime v1 Mini | Eleven Realtime v1 Max |
|---|---|---|
| Речевые рассуждения (Big Bench Audio) | 75.9% | 98.8% |
| Скорость отклика до первой речи (Time to First Audio) | 0.62 с (620 мс) | 0.57 с (570 мс) |
| Управление диалогом (Full-Duplex-Bench) | 95.8% | 94.1% |
| Пользовательские слепые тесты (Speech Agent Arena) | 988 баллов | 998 баллов |
| Вызов инструментов (Tool-use) | 60.3% | 87.1% |
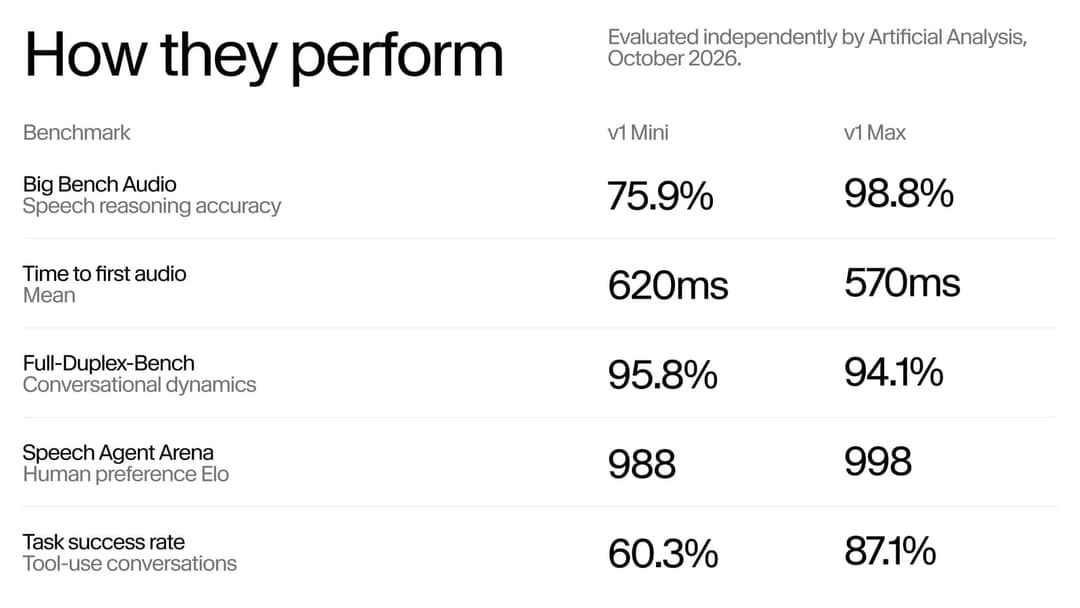
Разница в поведении видна сразу. Старшая модель v1 Max практически безошибочно решает устные логические задачи (98.8% верных ответов против 75.9% у младшей) и гораздо увереннее задействует внешние инструменты — 87.1% успешных вызовов против 60.3%. При этом младшая v1 Mini слегка обошла флагмана в тесте Full-Duplex-Bench, показав 95.8% точности в контроле пауз, смене реплик и поддакиваниях.
Подключение и развертывание
Для внедрения в продакшен предложено два маршрута:
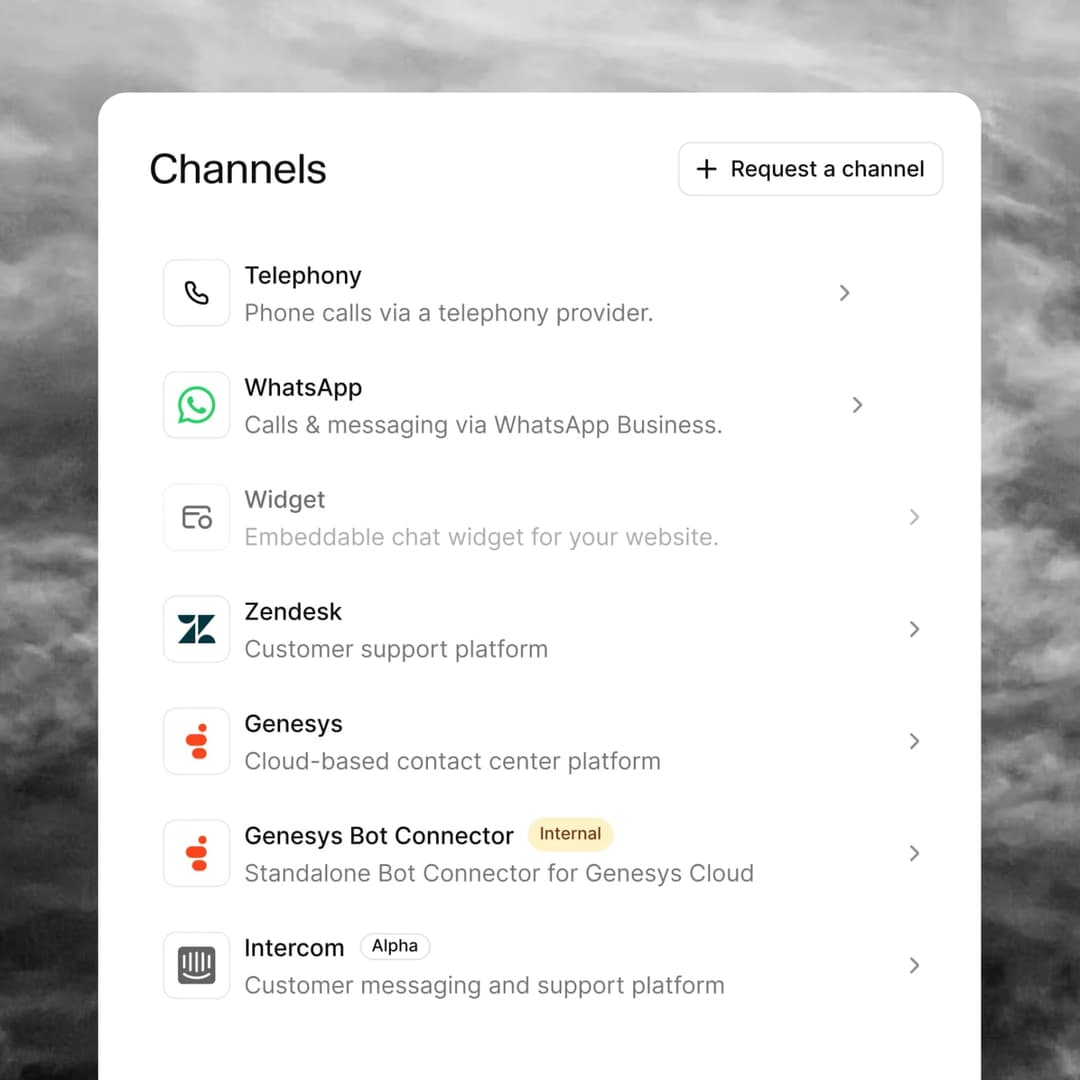
- Через платформу ElevenAgents: этот путь производитель рекомендует как основной. Панель позволяет настроить каналы связи (телефонные звонки, веб-виджеты, WhatsApp, контакт-центры CCaaS), сконфигурировать сценарии диалога, подключить собственные базы знаний, выставить защитные фильтры (guardrails) и мониторить работу агентов на проде.
- Через Realtime API: архитектура полностью совместима со спецификациями OpenAI Realtime API. Связка работает по протоколу WebSocket. Если проект уже использовал стандартный SDK от OpenAI, достаточно подменить параметры эндпоинта и идентификатор модели — например, на eleven_realtime_v1_mini. Если в стеке до этого применялся WebRTC, интеграцию потребуется предварительно перевести на WebSocket.
Для создателей бренд-активаций, интерактивных инсталляций и игрового продакшена здесь кроется вполне осязаемая выгода. Годами приходилось мириться с тем, что виртуальный промо-аватар или цифровой гид на стенде отвечает с неловкой двухсекундной паузой, напрочь убивающей правдоподобие момента. Теперь речь стартует за 570 миллисекунд — человеческий слух воспринимает такую паузу как естественный вдох собеседника.
Пожалуй, мы бы попробовали отдать этой связке озвучку интерактивного маскота для ближайшей выставки: семнадцать тысяч готовых тембров избавляют команду от многодневного кастинга дикторов. Когда время отклика падает до полусекунды, экранный персонаж наконец перестает звучать как растерянный автоответчик.