Французская Mistral представила голосовую линейку Voxtral 3
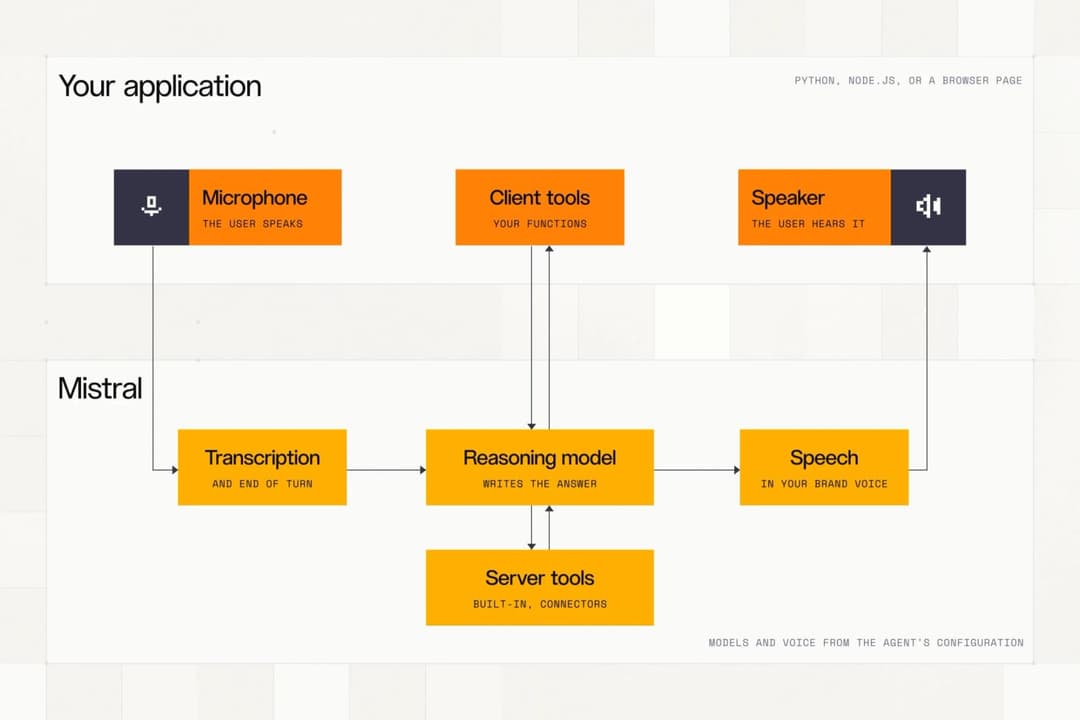
Знакомая пауза в диалоге с виртуальным собеседником обычно портит всё впечатление от интерактивного стенда или приложения: человек делает вдох, машина решает, что фраза окончена, и начинает бе бессвязно отвечать невпопад. Французская команда Mistral AI подошла к проблеме с инженерной педантичностью. Разработчик выкатил семейство речевых моделей и программный комплекс Voxtral 3. Это полноценный стек для создания разговорных агентов, умеющих слушать, соображать и говорить в реальном времени с минимальной задержкой.
Система состоит из модулей распознавания речи (speech-to-text), синтеза (text-to-speech) и коммуникационного SDK. Нас подкупило, что европейцы не стали собирать громоздкий комбайн, а разложили технологию по понятным слоям. С ними удобно экспериментировать при сборке интерактивных медиа, закадровой озвучке или прототипировании диалогов в видеопродакшене.
Распознавание без фальшивых пауз
Блок транскрипции закрывает сразу несколько сценариев. Флагманская модель Voxtral Small Transcribe 3 берет на себя тяжелую мультиязычную работу. Она поддерживает более 50 языков — от официальных языков Евросоюза до редких диалектов Азии и Индии. В модель сразу встроили диаризацию: алгоритм уверенно разделяет голоса разных спикеров в одном потоке. Для узкоспециализированных проектов полезна функция контекстного упреждения (context-biasing). В систему можно заранее загрузить перечень брендовых имен, профессионального сленга или сложных терминов, и транскрипция подхватит их без дополнительного дообучения нейросети.
Для бюджетных задач предусмотрена облегченная четырехмиллиардная модель Voxtral Mini Transcribe 3 на 4B параметров. Когда на первом месте стоит интерактив, подключается Voxtral Realtime Transcribe 3. Эта модель оптимизирована под 35 языков и держит аппаратную задержку на уровне менее 500 миллисекунд. Главная инженерная находка здесь — алгоритм предсказания конца реплики (end-of-turn prediction). Он опирается одновременно на акустические волны и семантический анализ фразы, поэтому ассистент перестает перебивать человека на полуслове.
Синтез, эмоции и собственный голос за полчаса
Голосовой движок Voxtral Mini TTS 3.0 генерирует речь на 35 языках и более чем 50 региональных диалектах. Модель на лету считывает смысл текста и сама выстраивает ритм, расставляет ударения и меняет эмоциональный окрас фразы. Если автоматики недостаточно, режиссуру можно взять в свои руки. Для точной настройки предусмотрены явные параметры управления — emotion, pacing и emphasis. С их помощью легко заставить голос звучать мягче, ускорить темп реплики или выделить ключевое слово в слогане.
Отдельным пунктом идет инструмент Pro Voice. Это технология клонирования голоса, которой требуется около 30 минут исходной аудиозаписи спикера. Система считывает тембр, индивидуальные интонации, манеру подачи и эмоциональный диапазон, после чего позволяет воспроизводить речь этого же человека на иностранных языках. Для озвучки локализованных рекламных роликов или адаптации игровых персонажей под разные рынки это выглядит крайне практичным решением.
Инфраструктура агентов и тарифная сетка
Чтобы связать слух и голос воедино, Mistral разработала агентский SDK на базе платформы LiveKit. Все этапы — расшифровка входного потока, рассуждения языковой модели вроде Mistral Small 4 и генерация ответа — запущены параллельно. Общая задержка диалога укладывается в пределы одной секунды на реплику. Агенты умеют ходить во внешние сервисы через function calling, искать информацию в сети и обращаться к закрытым базам данных. Под капотом есть нативная поддержка WebRTC для браузеров и мобильного софта, подключение к телефонии через SIP, а также интеграция с традиционными IVR-системами кол-центров.
Развернуть стек можно на облачных серверах Mistral в европейском контуре и по миру либо установить локально на собственном железе компании, если внутренние правила требуют строгого суверенитета данных.
| Сервис или конфигурация | Режим работы | Стоимость |
|---|---|---|
| Voxtral Mini Transcribe 3 | Пакетная транскрипция (batch) | $0,0035 за 1 минуту |
| Voxtral Mini Transcribe Realtime 3 | Потоковая транскрипция | $0,008 за 1 минуту |
| Voxtral Small Transcribe 3 | Пакетная расшифровка со словарями | $0,0040 за 1 минуту |
| Voxtral Speech 3 | Синтез речи (единый API для batch и realtime) | $13 за 1 млн символов |
| Голосовой агент на Mistral Small 4 | Полный цикл диалога | $0,04 за 1 минуту |
| Голосовой агент на альтернативной модели | Полный цикл диалога | $0,08 за 1 минуту |
В продакшене появляется внятная альтернатива закрытым американским экосистемам. Для дизайнеров впечатлений и медиахудожников это возможность оживить пространственные инсталляции без раздражающих задержек, а для продюсеров — способ быстро собирать черновые дикторские дорожки и многоязычные драфты прямо на этапе монтажа.
Когда цифровая речь перестает запинаться о собственную неловкость, диалог с экраном наконец становится естественным.