ActWorld научила генеративные мировые модели трогать предметы и открывать двери
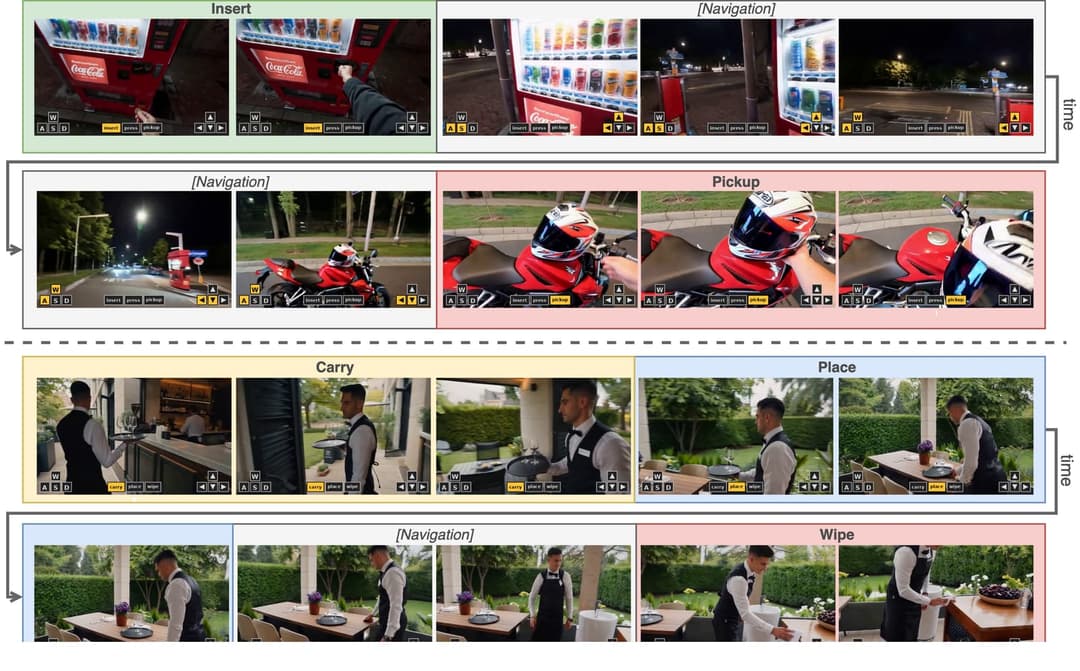
Привычный сценарий работы с интерактивными видеосетями всегда напоминал прогулку бесплотного призрака. Нажимаешь клавиши на клавиатуре — виртуальная камера послушно плывет по коридору или облетает комнату, но стоит попытаться протянуть руку к дверной ручке или взять чашку со стола, как генерация рассыпается в кашу. Большинство мировых моделей умеют водить зрителя по пространству, но пасуют перед физическим контактом с вещами. Любое действие до сих пор требовало жестко заданных сценариев в духе классического text-to-video.
Команда исследователей из Вашингтонского университета и подразделения Intelligent Creation в ByteDance решила сломать эту стеклянную стену. Их проект ActWorld, принятый на конференцию NeurIPS 2026, превращает генератор в полноценную интерактивную среду, где прямо во время непрерывной генерации можно взаимодействовать с объектами. Управление берется с привычной связки мыши и клавиатуры — работают раскладка WASD и стрелки, а кадры перестраиваются в реальном времени под команды пользователя.
Архитектура памяти и победа над амнезией
Разработчики выделили две ключевые причины, почему нейросети до сих пор не умели брать вещи в руки: дефицит обучающих данных и так называемое «забывание действий» (action-forgetting). Обычно сжатие истории кадров смещено к недавнему прошлому. Модель помнит, что происходило секунду назад, но начисто стирает моменты перехода событий — например, фазу, когда пальцы только коснулись предмета. Из-за этого дальнейшее состояние объекта теряет логику.
Чтобы преодолеть эти барьеры, инженеры собрали специализированный датасет из 100 тысяч видеороликов, разбитых на 40 категорий действий. Каждый 33-кадровый отрезок разметили с помощью мультимодальной модели с цепочкой рассуждений (CoT VLM), выделив плотные текстовые описания и конкретные фазы манипуляций. Архитектурный каркас ActWorld построен на чанк-авторегрессионном Diffusion Transformer (DiT), в который заложили иерархическую память (Hierarchical Action-Aware Memory):
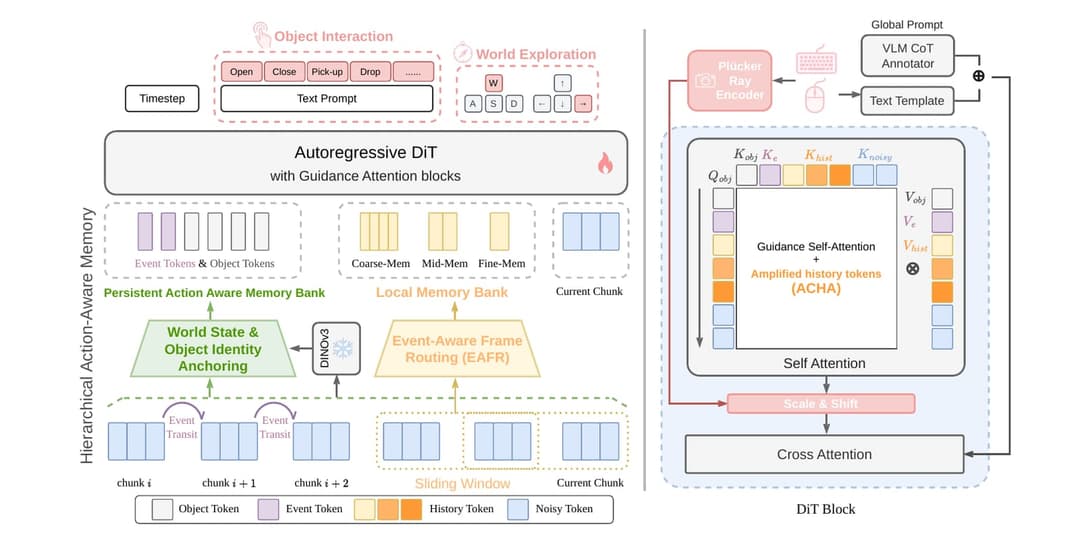
- Локальный банк памяти использует метод Event-Aware Frame Re-assignment (EAFR), который вычисляет критически важные для действия кадры внутри скользящего окна и усиливает их вес.
- Постоянный банк хранит компактные токены обновления событий (event-update) и идентификаторы объектов (object-identity), не давая тарелке или двери превратиться во что-то другое спустя десяток шагов.
- Двухветвевое кондиционирование связывает действия человека с физикой сцены: геометрическая ветвь считывает лучи Плюккера (Plücker rays) через общий модуль FiLM, а символическая транслирует словарь из 81 комбинации клавиш и мыши в текстовое пространство.
- Генерацию разогнали с помощью дистилляции в духе Helios: базовый учительский диффузор сократили с 50 шагов до 3, что позволило модели отвечать на нажатия клавиш без мучительных пауз.
Что показали тесты на бенчмарке I-Bench
Для проверки ActWorld авторы создали долгосрочный бенчмарк I-Bench, где навигация совмещена с непрерывными манипуляциями вроде связок «открыть/закрыть» или «открыть/поднять/поставить». Модель сопоставили с шестью заметными конкурентами: Yume 1.5, HY-World 1.5, Lingbot-World, Matrix-Game 3, Astra и Infinite-World.
Оценка семантической точности VLM-Action-Judge фиксирует, насколько точно система выполняет порученное действие по шкале от 0 до 3 баллов:
| Модель | Индекс следования (IF) | Полный успех (Succ., уровень 3) | Частичный успех (≥2) |
|---|---|---|---|
| ActWorld | 2.557 | 57.8% | 84.5% |
| Yume 1.5 | 1.638 | 20.12% | 46.75% |
| Lingbot-World | 1.635 | 19.89% | 49.91% |
| Astra | 0.949 | 5.83% | 19.36% |
| HY-World 1.5 | 0.709 | 5.19% | 18.70% |
| Matrix-Game 3 | 0.295 | 1.88% | 8.27% |
| Infinite-World | 0.237 | 1.51% | 3.95% |
В тесте на точность следования траекториям мыши и клавиш (Key-Mouse-Following по восстановленным траекториям SE(3)) ActWorld также показала высочайшую управляемость. Полная точность (Acc full) составила 20.62 против 20.00 у Matrix-Game 3, 11.43 у Astra, 9.17 у HY-World 1.5, 4.82 у Yume 1.5, 3.00 у Infinite-World и 2.67 у Lingbot-World. Точность следования клавишам (Acc keys) у разработки достигла 41.02, а движениям мыши (Acc mouse) — 43.67.
Перцептивные метрики VBench подтверждают стабильность картинки: модель сохраняет консистентность персонажа на уровне 0.871, фона — 0.896, демонстрирует эстетическое качество 0.485, показатель мерцания (temporal-flickering) 0.973 и общую согласованность 0.201. В демонстрациях видно, как желтая индикация активных клавиш WASD управляет камерой, а клики запускают физический контакт — коробка открывается, чашка берется со стола, и мир не мутирует в соседнюю текстуру.
Нас в этой истории подкупает практический разворот для визуального продакшена. Мы получаем инструмент, позволяющий арт-директору или моушн-дизайнеру не просто генерировать абстрактные пролеты, а режиссировать сцену руками — проверять мизансцены, ракурсы и контакт объектов прямо на лету, словно в игровом движке без предварительного 3D-моделирования. Кажется, видеогенерация наконец перестает быть кинотеатром для пассивного зрителя и превращается в осязаемое рабочее пространство.