Яндекс опубликовал в опенсорсе языковую модель Alice AI Foundation LLM
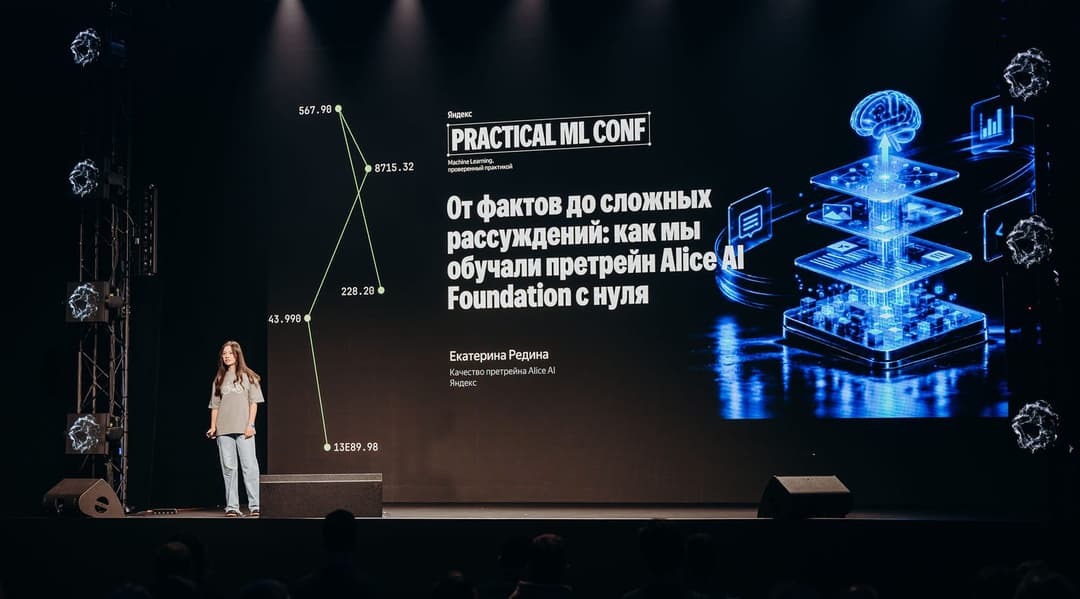
Яндекс впервые выложил в открытый доступ языковую модель, обученную полностью с нуля, а не дообученную поверх чужой архитектуры. Alice AI Foundation LLM — это претрейн-версия будущей большой модели компании, и по качеству ответов на русском языке она обходит многие мировые аналоги, особенно там, где нужны точные факты, интересные именно русскоязычной аудитории.
Архитектурно модель построена на принципе MoE (Mixture of Experts): формально в ней 80 миллиардов параметров, но в каждый момент времени работает только 3 миллиарда — отсюда и скорость, и низкая цена инференса. На олимпиадных задачах по математике модель делит лидерство с Qwen3.5-35B-A3B-Base, решая подавляющее большинство заданий, а в тестах на код обгоняет Nemotron-3-Super-120B-Base от NVIDIA — при том что задействует в четыре раза меньше активных параметров. На знаниях фактов модель обходит куда более крупный DeepSeek-V4-Flash-Base (284 млрд параметров, 13 млрд активных) и отвечает на уровне закрытой предыдущей модели самого Яндекса — у которой параметров втрое, а активных весов всемеро больше.
Для проверки фактических знаний на русском языке в компании собрали два собственных бенчмарка. WikiWebFacts — короткие пары «вопрос-ответ» про даты, определения и события на основе энциклопедий и частотных поисковых запросов. HardMultiQA устроен сложнее: он построен на обезличенном потоке реальных запросов к Алисе и охватывает более редкие темы — от медицины и права до IT и искусства, а модели приходится не вспоминать один факт, а выбирать сразу несколько верных вариантов или искать ошибку в тексте. Оба бенчмарка вместе с эталонными ответами и протоколом оценки выложены в открытый доступ — их может использовать кто угодно для сравнения любых моделей.
Часть релиза — это ещё и рассказ о том, как модель обучали. Инженеры перестроили оптимизатор так, чтобы пересылка данных между видеокартами шла параллельно с вычислениями — это ускорило шаги обучения примерно вдвое. Отдельная проблема была с отбором качественных обучающих данных: полная проверка корпуса ресурсоёмкой моделью потребовала бы больше 200 тысяч часов работы видеокарт. Вместо этого документы пропустили через каскад классификаторов — на каждом следующем этапе более дорогая модель обрабатывает уже меньше текста, — что сократило вычисления в десятки раз и сохранило около 95% полезных данных.
Модель распространяется по лицензии Apache 2.0 — значит, её можно свободно использовать и в исследовательских, и в коммерческих проектах. Для Яндекса это не самостоятельный продукт, а испытательный стенд: на архитектурных решениях Alice AI Foundation LLM компания обкатывает подходы для будущей единой рассуждающей модели, которая должна лечь в основу агентных сценариев Алисы — то есть способности выполнять за пользователя конкретные действия, а не просто отвечать на вопросы.