Viggle показала JST-2 для генерации 3D-сцен и готовых к анимации персонажей
Секунда на чипе NVIDIA B200 и меньше одного цента за итерацию — за это время новая модель Viggle собирает честную трехмерную сцену, готовую к просмотру в обычном браузере. Без долгой попиксельной оптимизации под каждый ракурс и без мучительной ручной настройки весов на скелете персонажа. Команда представила архитектуру JST-2 (Joint Space-and-Time), которая смотрит на генеративную графику не как на набор плоских картинок, а как на физическое пространство.
Стартап Viggle запустился в 2022 году. Первые два года ушли на обкатку первой версии JST-1 внутри собственного мессенджера — там аудитория перевалила за 50 миллионов пользователей, генерировавших забавные анимации. С 2024 по 2026 год инженеры с нуля собирали второе поколение системы, отказавшись от привычных костылей компьютерного зрения.
В основе JST-2 лежит концепция Physics-Native Tokens. Модель дробит виртуальный мир на персистентные атомы в трехмерных координатах xyz. Каждый такой атом хранит информацию о материале, визуальных атрибутах и векторах деформации, не теряя идентичности при движении. Архитектурный пайплайн включает пять ключевых звеньев: энкодер для перевода картинок в токены, мультимодальный генератор, декодер (он выводит данные в виде 3D Gaussian splats или рендеров с учетом углов обзора и приложенных сил), движок синтеза физических данных и отдельные пайплайны пре- и пост-тренинга.
Сцены за доли секунды и пространственный контекст
Вместо привычной пошаговой подгонки нейросетевых лучей инженеры применили фидфорвард-архитектуру. Пространство строится напрямую за один прямой проход. Модель способна удерживать в контекстном окне до 64 входных точек обзора, плавно расширяя локацию по мере добавления новых ракурсов. Полученное облако 3D Gaussian splats отправляется сразу на рендеринг на стороне клиента. Разработчики рассчитывают применять эту схему не только для виртуального продакшена, но и в симуляторах автономного вождения, строительстве и геодезии. В планах — текстовое управление объектами на границах локации и увеличение плотности сплатов.
Модели без скининга и риггинга
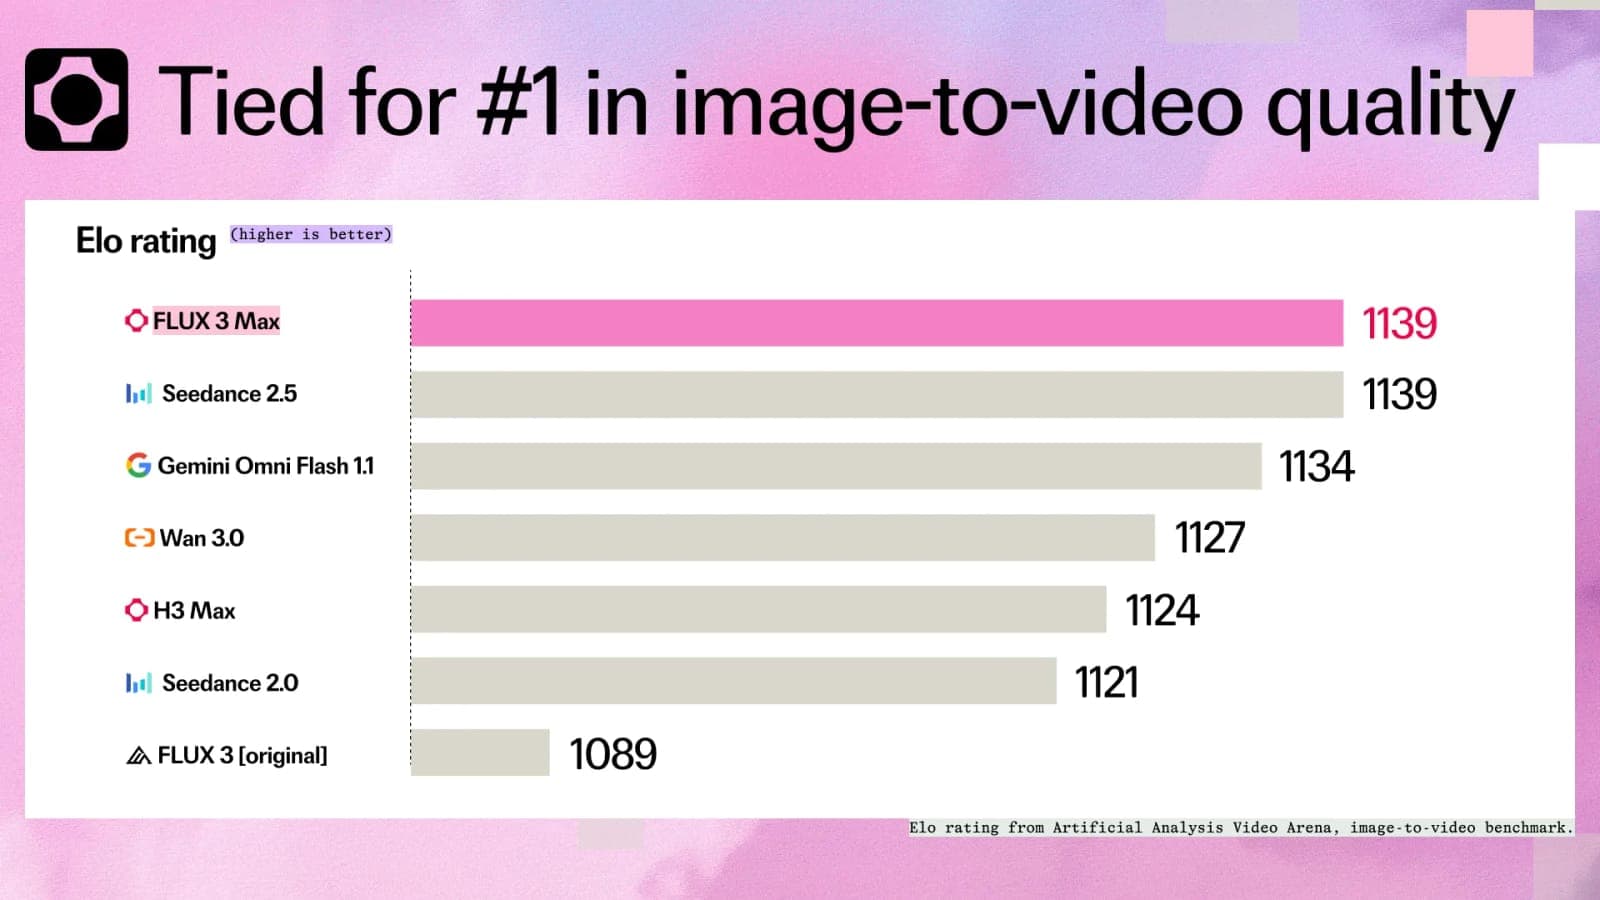
Для трехмерщиков главная новость в другом: JST-2 генерирует персонажей по текстовому запросу или одной картинке сразу со встроенной динамикой деформаций. Фазы риггинга и ручного скининга фактически выпадают из пайплайна — векторы подвижности уже зашиты в атомы тела и одежды. В слепых пользовательских тестах модель обошла решения Meshy 7.1 и Tripo H3.1 по детализации лиц, геометрии и пластике.
| Генерация персонажей | Против Meshy 7.1 | Против Tripo H3.1 |
|---|---|---|
| Средний балл | 58.4% | 73.2% |
| Качество одежды | 55.7% | 72.1% |
| Качество текстур | 56.8% | 70.8% |
| Качество тела | 56.8% | 74.2% |
| Проработка лица | 63.0% | 82.0% |
| Общее предпочтение | 59.9% | 66.9% |
Готовность меша к движению оценивали отдельно. Тестировщики сопоставляли совпадение суставов, удобство скелета и поведение пальцев.
| Готовность к анимации | Против Meshy 7.1 | Против Tripo H3.1 |
|---|---|---|
| Средний балл | 73.8% | 88.9% |
| Совпадение суставов | 65.6% | 85.9% |
| Удобство рига | 72.4% | 86.2% |
| Качество деформации | 77.6% | 93.2% |
| Риг кистей рук | 82.8% | 89.3% |
| Общее предпочтение | 70.6% | 89.6% |
Перенос пластики и захват видео
Модель анимирует персонажей как по текстовому описанию, так и по референсному видеоролику. Если исходное видео снято с неудачного ракурса, JST-2 сама достраивает траектории скрытых конечностей. Выходной моушн ложится на стандартные скелеты — например, на MetaHuman — без ретаргетинга и выравнивания скольжения стоп. На тестах генерации движений из текста систему сравнивали с Cartwheel Swing и HY-Motion-1.0, а видеотрекинг сопоставляли с Cartwheel Comic 4 и DeepMotion Animate 3D.
| Анимация по тексту | Против Cartwheel Swing | Против HY-Motion-1.0 |
|---|---|---|
| Средний балл | 74.8% | 80.0% |
| Следование промпту | 65.8% | 76.5% |
| Качество движения | 79.8% | 80.2% |
| Контакт стоп с полом | 73.0% | 80.7% |
| Общее предпочтение | 80.7% | 82.8% |
| Анимация по видео | Против Cartwheel Comic 4 | Против DeepMotion Animate 3D |
|---|---|---|
| Средний балл | 58.1% | 89.1% |
| Точность движений | 56.7% | 90.9% |
| Сложные и быстрые элементы | 56.0% | 86.2% |
| Плавность | 57.1% | 82.8% |
| Трекинг кистей | 57.9% | 95.0% |
| Общее предпочтение | 62.5% | 90.6% |
Сейчас Viggle уже проектирует JST-3. Если во второй версии движения персонажа завязаны на обученной динамике, то столкновения со средой и взаимодействие твердых тел пока еще опираются на правила традиционных физических движков. Следующий релиз должен перевести физику окружения на нейросетевую основу.
Нас подкупает смещение фокуса: вместо генерации изолированных статичных болванок индустрия подошла к созданию функциональных ассетов, которые не разваливаются при первом шаге в кадре. Рутинная подготовка персонажа к шоту — от посадки на риг до чистки захваченных с видео пальцев — перестает быть отдельным этапом пайплайна.