Suno научилась сводить дикторский голос и фоновую музыку в единый трек
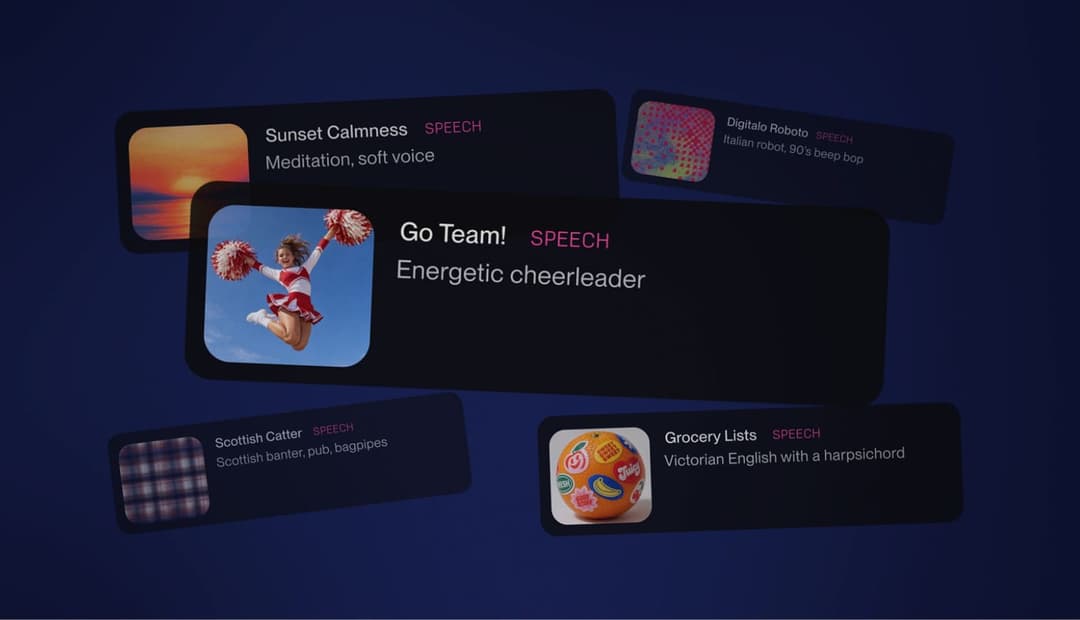
Обычную текстовую заметку из телефона или неловкое сообщение из рабочего чата теперь можно превратить в кинематографичный этюд с драматичной партитурой на фоне. Музыкальный сервис Suno перевел в открытую бету инструмент Speech — отдельную аудиомодель, которая берет на себя сразу две задачи: синтезирует разговорную речь и одновременно подкладывает под нее оригинальный инструментальный трек. Никакого отдельного сведения в секвенсоре, монтажа дорожек и подгонки громкости — на выходе получается цельный аудиофайл.
До этого момента генерация аудио в креативных пайплайнах почти всегда распадалась на два изолированных процесса. Сначала приходилось генерировать дикторский голос в специализированных сервисах, затем искать подходящую подложку на стоках или в генераторах музыки, а после вручную давить частоты эквалайзером, чтобы слова не тонули в гитарах или синтах. Разработка Suno решает эту связку на уровне одной модели.
Как устроена генерация
Инструмент встроили прямо в основной интерфейс платформы. Механика взаимодействия построена на двух шагах, знакомых любому, кто работал с текстовыми генераторами:
- Пользователь вводит текст, который должен прозвучать: отрывок истории, стихотворение, мотивационную речь, детскую сказку или банальную голосовую заметку.
- В отдельном поле текстом задаются параметры подачи: желаемый тембр голоса, манера речи и жанровый стиль фонового саундтрека.
Месяц закрытого тестирования с небольшой группой пользователей показал довольно широкий разброс сценариев. Сами разработчики экспериментировали с абсурдными форматами вроде нарочито пафосного чтения бытовых смс-переписок под масштабный оркестр, оформляли медитативные практики и начитывали терапевтические тексты на ночь. Команда прямо называет это направление «креативными развлечениями» — по их оценке, именно подобные гибридные форматы сформируют следующую волну потребительских медиатехнологий.
Ограничения беты и шероховатости
Модель пока находится в тестовом статусе, поэтому без артефактов не обошлось. Разработчики честно предупреждают о специфических багах ранней версии. Например, британский акцент посреди монолога может неожиданно съехать в сторону австралийского произношения, а драматические паузы между предложениями порой затягиваются сверх всякой меры. Дорабатывать алгоритмы планируют по ходу дела, опираясь на отзывы сообщества.
На демонстрационных материалах релиза сервис также показывает смежные инструменты экосистемы — включая поколение музыкальных моделей версии v6 и студийные опции сведения вроде эквалайзера и компрессии в Suno Studio. Похоже, платформа последовательно собирает под одной крышей полноценный звуковой продакшен полного цикла.
Для дизайнеров, моушн-дизайнеров и арт-директоров такой инструмент интересен прежде всего как быстрый генератор чернового звука под кейсы, шоурилы, аниматики и рекламные питчи. Собрать внятный черновой войсовер с идеально подходящим по настроению эмбиентом теперь можно буквально за пару минут — пока клиент или команда еще смотрят раскадровку.
Собрать готовый аудиоролик из сырого текста теперь можно ровно за один промпт