Shengshu показала генерацию интерактивного видео на лету с линейкой Vidu S
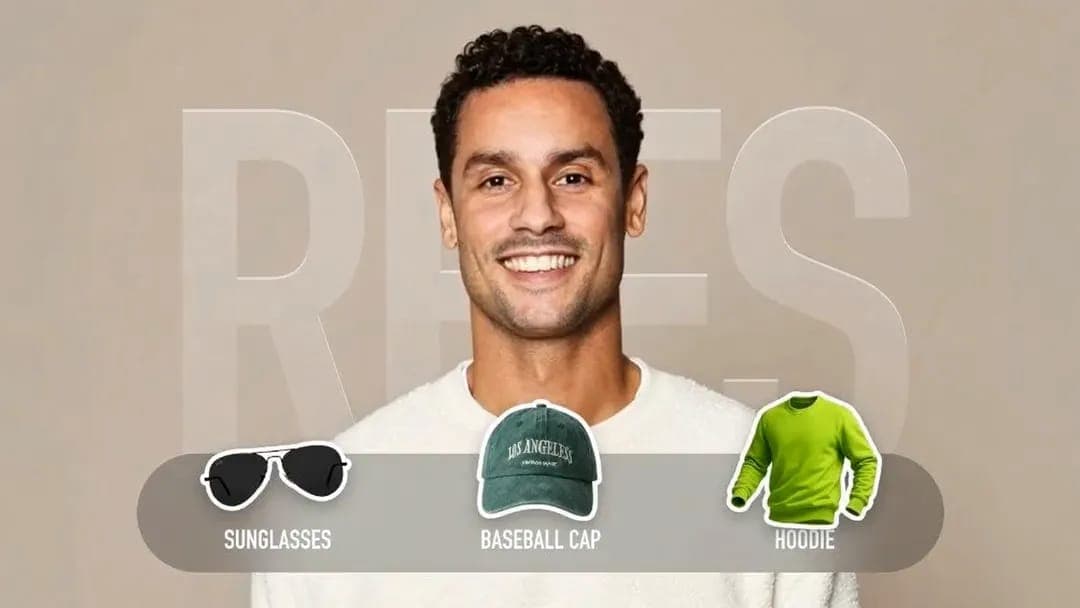
Вы отправляете в видеопоток новую картинку прямо посреди трансляции, говорите пару слов в микрофон, и цифровой персонаж на экране без секундной паузы меняет одежду, продолжая сложный танец. Интерактивная видеогенерация на глазах перестает быть историей про бесконечное ожидание рендера одного кадра. Китайская компания Shengshu-ai выкатила семейство моделей Vidu S, созданных именно для потоковой работы в реальном времени.
В линейку вошли две системы: более ранняя Vidu S1, вышедшая в июле 2026 года, и свежая Vidu S2, представленная в сентябре того же года. Главный упор разработчики сделали на скорость отклика и управляемость прямо во время эфира, избавившись от классического барьера пакетной обработки.
Архитектура Vidu S2 и живой монтаж
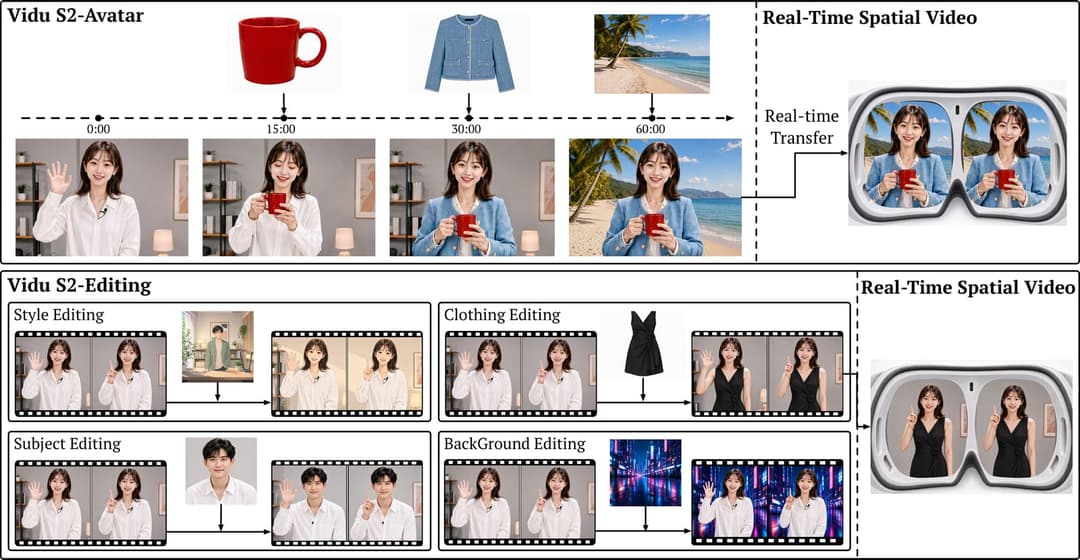
Флагманская Vidu S2 значительно поднимает планку качества картинки и вариативности управления. Модель разделена на специализированные функциональные блоки:
- Vidu S2-Avatar: генерирует видеопоток в разрешении 720p с кадровой частотой от 25 до 42 кадров в секунду. Модуль справляется со сложной хореографией и динамикой движений, позволяя на лету подмешивать новые референсные изображения прямо в процессе текущего стрима.
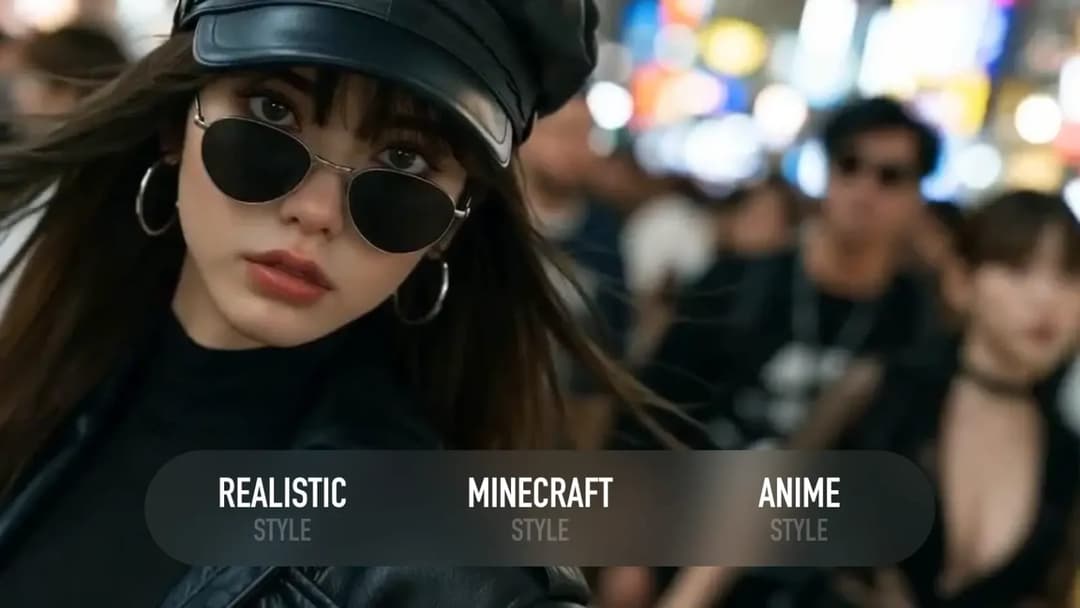
- Vidu S2-Editing: отвечает за трансформацию живого входящего сигнала по статичным картинкам-образцам. Сюда зашиты виртуальная примерка одежды (virtual try-on), стилизация, моментальная замена фона или самого героя без потери исходной пластики движений.
- Пространственный режим: формирует синхронизированные стереопары под гарнитуры виртуальной реальности и иммерсивные экраны.
Долгая непрерывная генерация обычно страдает от деградации картинки, когда мелкие артефакты накапливаются от кадра к кадру и превращают сцену в кашу. Чтобы решить эту проблему, инженеры Shengshu-ai применили метод обучения Self-Replay Forcing: модель тренировали на ее собственных зашумленных траекториях генерации. Для запуска на сравнительно недорогом потребительском железе разработали связку TurboDiffusion и TurboServe. Она объединяет квантование матричных умножений (low-bit GEMM), эффективные механизмы внимания (efficient attention), кастомные вычислительные ядра и многопроцессорный конвейеринг.
Голосовой контроль в Vidu S1
Июльская модель Vidu S1 проектировалась как решение для быстрого создания диалоговых аватаров. Она работает с разрешением 540p на скорости до 42 кадров в секунду на обычных потребительских видеокартах. Главная фишка первой версии — прямое управление голосом: персонаж слушает устные команды пользователя и мгновенно перестраивает свое поведение в кадре. Система одинаково гладко оживляет живых людей, стилизованных аниме-героев, домашних животных и кастомных маскотов.
| Параметр | Vidu S1 | Vidu S2 |
|---|---|---|
| Дата выхода | Июль 2026 | Сентябрь 2026 |
| Рабочее разрешение | 540p | 720p |
| Скорость генерации | До 42 FPS | 25–42 FPS |
| Фокусные задачи | Голосовой интерактив, аватары людей и животных | Живой монтаж, примерка, сложный моушн, стереопары VR |
| Научная публикация | arXiv:2607.03118 | arXiv:2609.11638 |
Интеграция и доступ для разработчиков
Опробовать возможности Vidu S2 авторы предлагают на официальном сайте платформы. Для тех, кто планирует встраивать генератор в свои продакшен-пайплайны, компания подготовила документацию и спецификации API на английском и китайском языках, включая готовые сценарии быстрого старта для S2-Avatar и S2-Editing. Не забыли и про автоматизацию: для ИИ-агентов Claude Code, Codex и OpenClaw доступен специальный навык vidu-s-api.
Для креативных команд и моушн-дизайнеров это открывает понятный прикладной сценарий: интерактивные стримы, цифровые шоурумы с моментальной сменой луков и виртуальные витрины больше не требуют многонедельного пререндера. Нас подкупило то, что Shengshu делает упор на оптимизацию под доступные видеокарты, а не закрывает технологию в недосягаемых кластерах. Стрим становится пластилином прямо в момент эфира.