Открытая нейросеть Ming-Image собирает макеты и раскладывает их по слоям
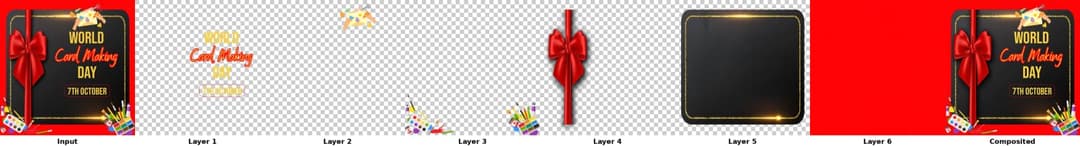
Знакомая пытка любого моушн-дизайнера и арт-директора начинается одинаково: генеративка выдает красивую плоскую картинку, после чего ты открываешь Photoshop и два часа вручную вырезаешь пером типографику, тени и плашки, замазывая образовавшиеся дыры штампом. Проект inclusionAI решил подойти к проблеме с инженерной прямотой. Команда выложила в открытый доступ линейку моделей Ming-Image-0.1-Design с архитектурой на 6 миллиардов параметров. Эти нейросети умеют не просто рендерить сложную верстку, но и автоматически препарировать готовый плоский растр на чистые прозрачные слои.
Линейка разделена на две независимые модели по 6 миллиардов параметров каждая. Первая, Ming-Image-0.1-Design, отвечает за создание законченных дизайн-макетов. Ей по силам интерфейсы мобильных и веб-приложений, комплексная инфографика, рекламные постеры и баннеры с обилием наборного текста. Вторая модель, Ming-Image-0.1-Design-Layer, решает обратную инженерную задачу — берет плоский графический файл и раскладывает его на независимые прозрачные слои в формате RGBA с альфа-каналом.
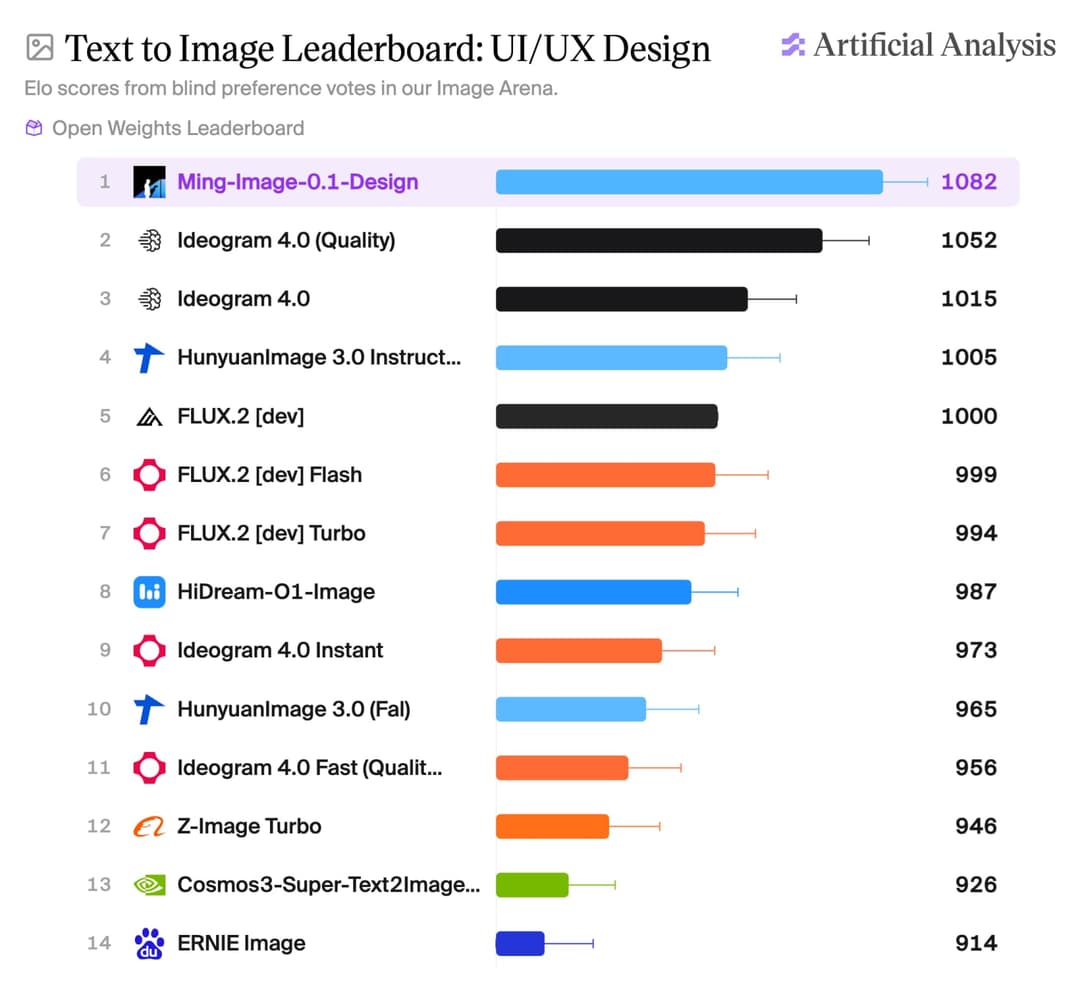
Структура вместо слепой диффузии
Создатели отказались от концепции слепого промптинга, когда нейросеть наугад смешивает пиксели. Чтобы интерфейсы и постеры получались ровными, пайплайн генерации опирается на структурированные данные. Пользовательский текстовый запрос сначала подхватывает инструктивная визуально-языковая модель — разработчики предлагают связки с Ling-3.0-flash-VL или qwen3.8-27B. Она переводит короткую фразу в строгий JSON-объект, напоминающий внутреннее дерево макета в Figma: с точными координатами контейнеров, четкой иерархией элементов и спецификациями цветов.
Если требуется получить объект сразу с альфа-каналом без фона, текстовый энкодер распознает специальные маркеры вроде «isolated subject, alpha matte, no background» или китайский аналог «带透明通道,4通道RGBA图像». Диффузионный трансформер генерирует графику строго внутри заданных координат, сохраняя прозрачность фоновых зон.
Вторая модель, Ming-Image-0.1-Design-Layer, берет на себя роль ассистента по предпечатной подготовке или моушн-нарезке. Ей можно скормить плоский референс и задать команду вида «Decompose this image into N layers». Модель автоматически распознает логику композиции и аккуратно разделяет исходник, к примеру, на шесть изолированных PNG-слоев. Процесс упорядочен строго сверху вниз: на передний план выносятся текстовые блоки и плашки интерфейса, в средние слои попадают ключевые графические объекты, а в самый низ уходят фоновые текстуры, подложки и мягкие тени.
| Задача | Шаги диффузии (Steps) | Шкала соответствия (CFG) | Доступные бакеты разрешения | Рекомендуемое разрешение |
|---|---|---|---|---|
| Текстовая генерация макета | 12 | 1.0 | 1024, 2048 | 2048 |
| Декомпозиция растра на слои | 12 | 2.0 | 512, 1024 | 1024 |
В генеративном режиме модель собирает строго квадратные композиции на 1024 или 2048 пикселей. Режим декомпозиции устроен гибче: он бережно относится к пропорциям оригинальной картинки, автоматически подгоняя ее габариты под ближайший поддерживаемый бакет в 512 или 1024 точки.
Интеграция в пайплайны и системные аппетиты
Разработчики сопроводили релиз готовыми агентскими сценариями. Первый навык, Ling UI Design, помогает автономным агентам анализировать сгенерированные интерфейсы и на основе полученных слоев писать чистый фронтенд-код с верификацией верстки. Второй сценарий, Image to Editable PPT, превращает концепт слайда в полноценную презентацию PowerPoint. На выходе получается не скриншот, а рабочий файл .pptx, где текст остается нативным редактируемым текстом, а подложки превращаются в векторные автофигуры.
Железо под эту архитектуру понадобится серьезное. Для стабильной работы обеих моделей в режиме максимального качества требуется один ускоритель с объемом видеопамяти от 80 GiB в точности BF16. Запуск возможен в среде Python 3.10 или новее с библиотекой PyTorch под CUDA. Для ускорения математики поддерживается FlashAttention 2 через флаг --attn-implementation flash_attention_2, хотя стандартным CLI-режимом остается eager — сама языковая часть поддерживает только его и FlashAttention 2, тогда как диффузионный трансформер опирается на стандартный механизм PyTorch SDPA. Разворачивать продакшен-сервис авторы рекомендуют на базе фреймворка vLLM-Omni.
Внутренняя механика моделей тоже различается на уровне чекпоинтов в файле transformer/config.json. Генеративная ветка использует параметр alignment_padding_mode: "zero_masked" и флаг multi_frame_output: false. У модели разделения слоев эти значения выставлены как "learned" и true — так система удерживает контекст сразу нескольких кадров-слоев. За сжатие и декодирование скрытого пространства в обоих случаях отвечает четырехканальный VAE-компонент AutoencoderKLQwenImage. Для проверки развертывания авторы предусмотрели юнит-тесты профиля инференса и паддинга, а также сквозной смоук-тест tests.test_inference_smoke.InferenceSmokeTest.test_two_step_showcase_smoke.
Для дизайн-отделов и продакшенов это первый серьезный шаг к тому, чтобы вытащить нейросети из категории «генераторов красивых картинок для мудборда» в реальный производственный конвейер. Когда диффузия начинает отдавать макет структурированным деревом слоев, а не намертво спекшимся джипегом, отпадает половина рутинной обтравки. Мы бы с удовольствием посмотрели на связку такого пайплайна с After Effects — оживлять баннеры и промо-страницы станет в разы быстрее.