Миллион токенов на выходе и 800 тысяч строк кода за раз: Google показала Gemini 4 Argon
Представьте генерацию, которая не захлёбывается на полуслове и не просит разбить задачу на десять мелких кусков: система выдаёт сразу готовый монолитный массив. Именно этот порог попытались убрать инженеры Google, выкатив 30 сентября свою новую флагманскую модель Gemini 4 Argon. Главная цифра релиза — ровно один миллион токенов на вывод за один проход. Для сравнения, предыдущее поколение спотыкалось о планку в 64 тысячи. В визуальном продакшене и интерактивной разработке это разница между бесконечной склейкой фрагментов вручную и возможностью получить огромный рабочий пайплайн за одну итерацию.
Появление Argon прервало более чем семимесячную паузу: Google с 19 февраля 2026 года (когда вышла Gemini 3.1 Pro, последовавшая за базовой Gemini 3 от 18 ноября 2025 года) не обновляла модели старше линейки Flash. Новинка позиционируется как полноценный фронтирный инструмент для тяжёлой инженерии, корпоративной автоматизации, финансов и кибербезопасности. При этом входной контекстный лимит разработчики пока держат в секрете, сосредоточившись на демонстрации автономности рассуждений.
Прежде чем показывать систему публике, её обкатали на собственной серверной инфраструктуре Google. Результаты вышли вполне осязаемыми: автономные агенты Argon разобрали телеметрию дата-центров и оптимизировали управление памятью, высвободив более 300 TiB (ожидаемый совокупный эффект компания оценивает в диапазоне от 500 TiB до 1 PiB). В экспериментах исследователей Google Quantum модель взялась за минимизацию квантовых вычислительных подзадач по балансу кубитов и вентилей и за несколько минут превзошла опубликованный базовый уровень на 40%. Параллельно алгоритм бросили на миграцию софта с небезопасных C/C++ на Rust. Нейросеть переписала ядро Fuchsia Zircon размером свыше 800 000 строк кода, библиотеку re2, а в видеодекодере libgav1 заменила 32 000 строк SIMD-кода безопасным аналогом на Rust — после такой пересборки декодер заработал в 2,7 раза быстрее прежнего порта.
Замеры производительности и тесты
Внутренние тесты Google фиксируют превосходство Argon над GPT-6 Astra и Claude Opus 5.5 на 13 из 19 профильных бенчмарков. Всего новинка прошла 22 стандартных испытания и в 20 из них зацепилась за верхнюю пятёрку. На текстовом лидерборде Arena по состоянию на 30 сентября конфигурация высокой производительности Argon взяла первое место на базе 4942 голосов, хотя статус результата пока помечен как предварительный. В сводке Artificial Analysis в категории глубоких рассуждений модель набрала 53 балла — ровно столько же у GPT-6 Astra, тогда как Gemini 3.1 Pro Preview держалась на отметке 30.
| Бенчмарк / Метрика | Результат Gemini 4 Argon | Контекст и соперники |
|---|---|---|
| DeepSWE v1.1 (программная инженерия) | 77,9% | Новый отраслевой рекорд SOTA |
| LVBench (анализ длинных видео) | 91,7% | Первое место в понимании медиа |
| Vals Index (прикладные бизнес-задачи) | 68,9% | Лидерство в праве, налогах и коде |
| AutomationBench Zapier | 51,3% | Первое место в связках автоматизации |
| CWE-bench v1 (исправление уязвимостей) | 68,0% | Разделённая верхняя строчка |
| Terminal-Bench (работа в консоли) | 57,6% | Рывок с прежних 19% |
| Юридические сценарии | Превосходство в 7 раз | По числу решений против Claude Sonnet 5.5 |
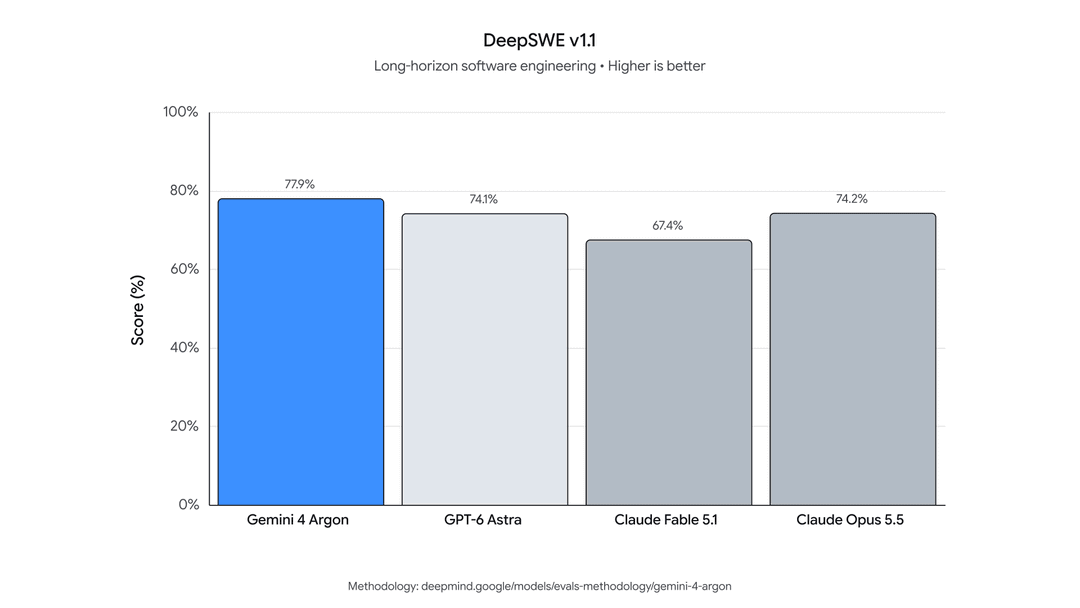
По расчётам разработчиков, модель выполняет поставленные задачи примерно вдвое быстрее аналогов, сжигая при этом вчетверо меньше токенов. В бенчмарках Vals Finance Agent v2 и Harvey's Legal Agent система забрала ведущие оценки за многоэтапный поиск информации и подготовку финальных отчётов. Для тех, кто собирает комплексные визуальные проекты с тысячами ассетов, особенно показателен результат в LVBench: разбор длинного видео с точностью 91,7% открывает дорогу к автоматическому логгингу сырых съёмочных смен без потерь.
Защита и доступ
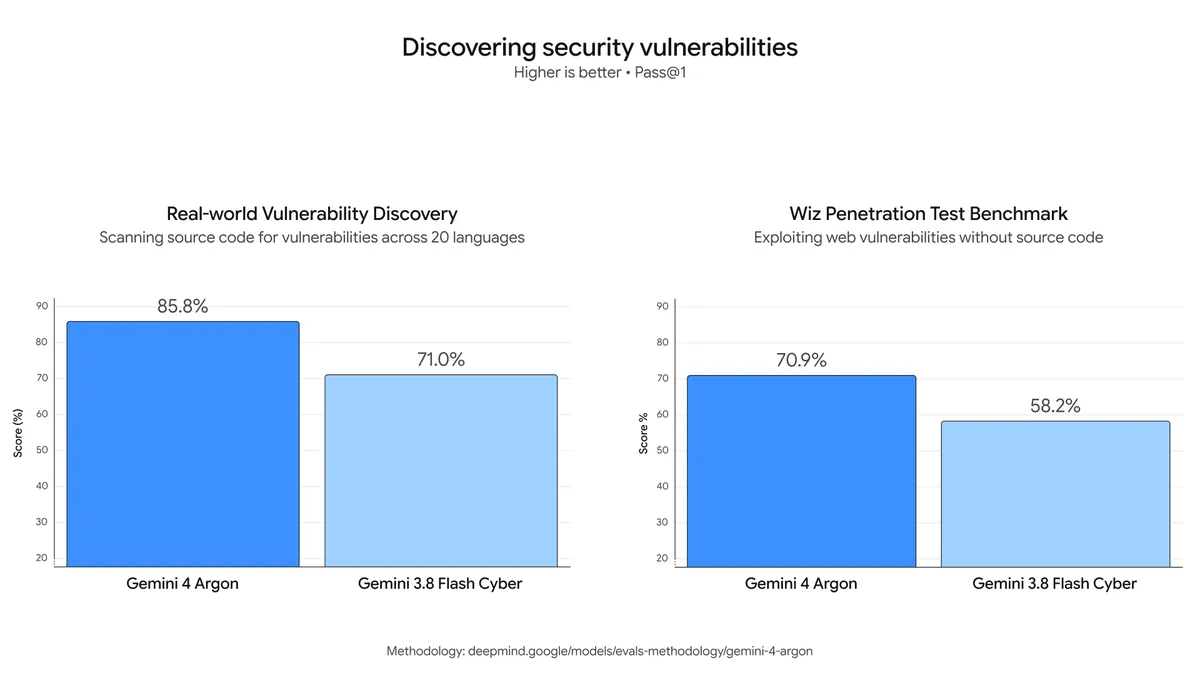
Модель обучили автономно находить и закрывать баги в исходниках на 20 языках программирования. Компания Wiz подключила Argon к благотворительной программе Scan for Good, где алгоритм сумел выявить критическую брешь в софте для больниц по всему миру — уязвимость, которую пропустили другие фронтирные сетки. В слепых испытаниях на анализ веб-инфраструктуры система обошла специализированную 3.8 Flash Cyber. При этом авторизованные защитники из программы Fairwind Program получают модель без стандартных фильтров кибербезопасности, чтобы тестировать атаки в реальных условиях. Саму инфраструктуру упаковали в изолированные песочницы, добавив сквозной трекинг внутренних активаций и цепочек рассуждений для борьбы с отклонениями от инструкций и атаками непрямых промпт-инъекций (где система лидирует на тесте Gray Swan IPI).
Прямо сейчас развёртывание строго ограничено: кроме участников Fairwind Program и регуляторных органов США, ведущих добровольную предварительную проверку, доступ закрыт. Широкий запуск для корпоративных клиентов, разработчиков через API и подписчиков тарифа Google AI Ultra намечен на следующий этап раскатки.
Экономику API выстроили с прицелом на агрессивный промопериод. На старте ввод стоит $2 за миллион токенов, а вывод — $10 за миллион. Кэширование контекста отдают с колоссальным дисконтом в 95%. По подсчётам Artificial Analysis, решение одной комплексной задачи в Intelligence Index обходится модели примерно в $1,99 против $3,26 у GPT-6 Astra. После завершения промо-окна (сроки которого разработчики не раскрывают) расценки поднимутся ровно вдвое: до $4 за входные токены, $20 за выходные, а стоимость кэширования вырастет в два раза, доведя цену задачи до $3,98.
Нас подкупило, что Google перестала размениваться на бесконечные микро-апдейты легковесных сеток и выкатила систему для тяжёлых сквозных процессов. Когда в одну сессию можно скормить часы съёмочного материала, получить детальный лог, параллельно написать логику шейдеров и скомпилировать рабочий плагин без опасения упереться в лимит ответа — характер работы с медиа меняется бесповоротно. Ждём открытия API: проверять такие объёмы на реальном продакшене предстоит уже без скидок на сырость технологии.