LensErase начисто стирает с постеров объекты и тени без текстовых подсказок
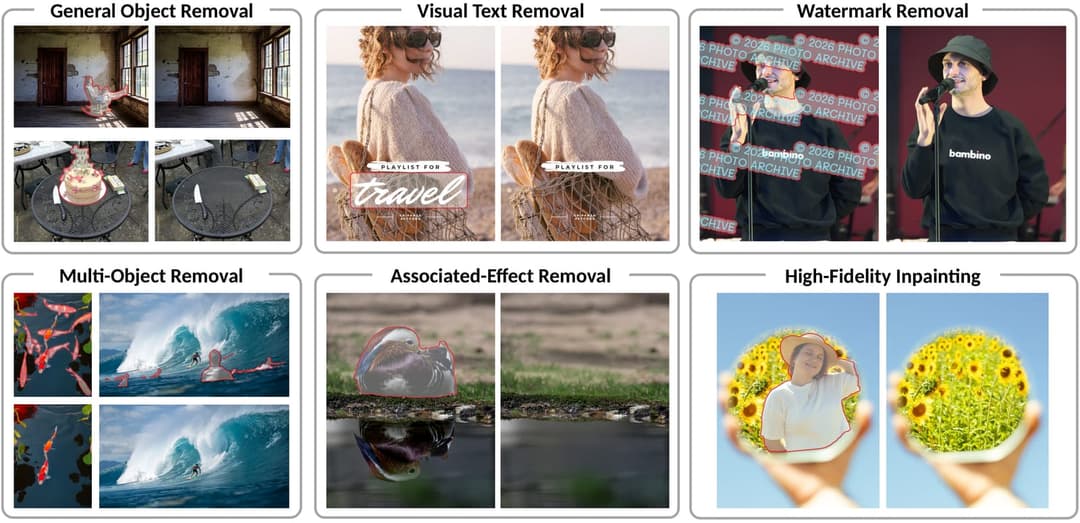
Знакомая сцена на этапе чистовой ретуши: маска аккуратно обводит лишний фонарный столб или случайного прохожего, генеративный заливщик послушно убирает силуэт, но оставляет на асфальте сиротливую тень, а соседнюю витрину размазывает в мыло. Приходится либо вручную вычищать полупрозрачный след штампом, либо мучительно формулировать текстовый запрос, надеясь, что нейросеть поймет структуру асфальтовой крошки. Исследовательская команда из Шанхайского университета транспорта (Цзяо Тун), Нанькайского университета, Научно-технического университета Китая (USTC), Университета Сиднея, Пекинского университета и корпорации Microsoft предложила закрыть эту рутину фундаментальной моделью LensErase.
Система создана для точечного удаления любых визуальных помех — от людей и случайного мусора до типографики и полупрозрачных копирайтов. Главный принцип работы здесь предельно утилитарен: от автора не требуют текстовых промптов. Нужны только исходная картинка и маска зоны, которую необходимо стереть. При этом модель обучена одновременно вычислять и зачищать сопутствующие визуальные эффекты вроде падающих теней или отражений на мокрой брусчатке, не повреждая исходный фон вокруг.
Архитектура без текстовых костылей
В основу проекта легла предварительно обученная текстово-визуальная модель Lens, изначально созданная для генерации изображений по тексту. Инженеры переосмыслили ее архитектуру для задач стирания контента, применив адаптацию Mask-Aware RoPE (Rotary Position Embedding). Чтобы гарантировать сохранность остального кадра, авторы внедрили алгоритм TraceFusion. Он анализирует остатки изображений (image residuals), жестко фиксирует границы вмешательства и изолирует зону правки от остального макета.
Обучение проходило в два ключевых этапа: контролируемая тонкая настройка (supervised fine-tuning, SFT) и контракт-ориентированное обучение с подкреплением (contract-guided reinforcement learning, RL). Это научило сеть справляться с многослойными композициями и сложными типографическими постерами, где буквы наложены на текстурированные фоны и полупрозрачные градиенты.
Датасет LensErase-100M
Масштаб подготовки данных впечатляет: под проект собрали тренировочный датасет LensErase-100M, включивший 101,07 миллиона согласованных триплетов «входное изображение — маска — целевой результат». Исходники брали с фотобанков Pexels и Wikimedia Commons, а также из профессиональных графических наборов Crello на Hugging Face, EntitySeg на GitHub, UHRSD (PGNet) и HRS10K (RMFormer). Тестовые водяные знаки генерировали синтетически.
Весь массив из 101,07 миллиона примеров претренинга разделили на пять предметных категорий:
- Общие изображения (General): 77,6 млн примеров;
- Водяные знаки (Watermark): 9,99 млн примеров;
- Постеры со сложной версткой (Poster): 8,02 млн примеров;
- Крупные маски (Large mask): 4,02 млн примеров;
- Визуальный текст (Visual text): 1,44 млн примеров.
Поверх базовой выборки авторы подготовили 140 тысяч SFT-образцов повышенного разрешения, прошедших строгий отбор моделью GPT-5.6 Sol по четырем критериям: корректность правок, валидность контура маски, точность реконструкции и сохранность фона. Финальный этап шлифовали на 19 тысячах RL-примеров со специализированной системой наград для разных графических доменов.
Тестирование и бенчмарк LensErase-Bench
Оценивать качество затирки решили на собственном тестовом наборе LensErase-Bench из 500 кейсов. В бенчмарк вошли 200 общих сцен, 100 сложных постеров, 100 примеров с текстом и 100 кадров с водяными знаками. Главная особенность теста в том, что модели не требуется идеальное парное изображение-эталон (ground-truth): инспекцию проводит GPT-5.6 Sol по четырехбалльной шкале (от 0 до 4).
| Критерий | Доля в итоговой оценке | Что проверяет алгоритм |
|---|---|---|
| Removal | 40% | Полное удаление целевого объекта, теней и световых следов |
| Inpainting | 20% | Качество и согласованность дорисовки скрытого фона |
| Preservation | 20% | Сохранение нетронутых участков кадра и геометрии макета |
| Cleanliness | 20% | Общая чистота кадра, отсутствие шума и паразитных артефактов |
На основе этих метрик авторы вывели жесткий стандарт качества HiFi Removal. Кейс признается безупречным только тогда, когда модель получает максимальные 4 балла за чистоту удаления объекта (Removal) и не менее 3 баллов по остальным трем параметрам. В тестах LensErase сопоставили как с закрытыми коммерческими продуктами (Flux2-Erase и ориентированной на маски GPT-Image2.5-Sunburst), так и с известными открытыми моделями — OmniPaint, OSOR, ObjectClear, GeoRemover и RORem-mixed.
Над созданием фундаментальной модели работала исследовательская группа из четырнадцати авторов: Yunuo Chen, Xiuyu Wu, Qinhong Yang, Jinjing Zhao, Yanchen Dong, Sirui Zhang, Dong Chen, Fangyun Wei, Lei Shi, Ji Li, Dongdong Chen, Guo Lu, Yan Lu и Baining Guo. Исходный код разработки пока закрыт, но команда обещает выложить его в открытый доступ в репозитории на GitHub.
Для дизайнеров, арт-директоров и моушн-дизайнеров появление такого инструмента означает конец утомительной борьбы с остаточными тенями и размытыми текстурами при подготовке ассетов. Если демо не врет, то очистка рекламного постера от старого брендинга или локализация графики перестанет требовать филигранного владения штампом и танцев вокруг генеративных промптов — достаточно будет просто обвести ненужное широкой кистью.
Идеальный инструмент ретушера на самом деле должен быть невидимкой: нажал кнопку — и предмет просто перестал существовать.