GPT-6 Astra Ultrafast на чипах Blackwell ускоряет генерацию в восемь раз
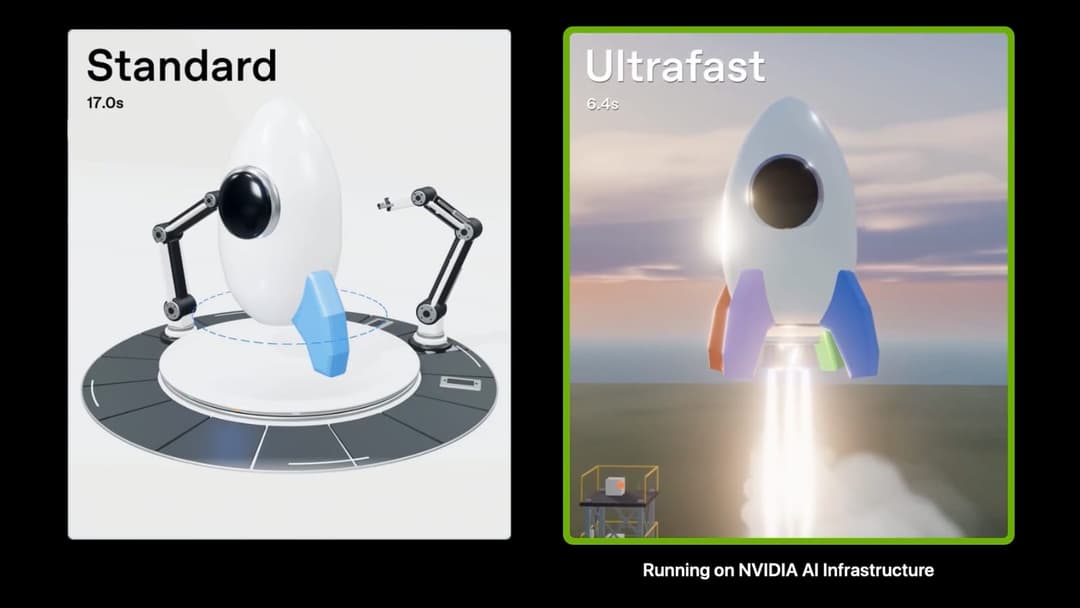
Курсор на экране замирает на несколько секунд всякий раз, когда сложный программный агент пытается связать между собой внешние инструменты или переписать увесистый скрипт. В этот момент интерактивность рассыпается. Затяжная пауза между запросами превращает рабочий диалог с нейросетью в утомительное ожидание ответа по почте. 1 октября 2026 года в официальном блоге NVIDIA появился анонс, призванный переломить эту привычку. Разработчики представили результаты совместного инженерного проекта с OpenAI: генеративный режим GPT-6 Astra Ultrafast, переведенный на архитектуру NVIDIA Blackwell.
Главная метрика здесь не требует долгих пояснений: скорость генерации токенов в новом режиме увеличилась до восьми раз относительно базового Astra Standard. Прирост не остался лабораторным рекордом для закрытых презентаций. Интеграцию сразу выкатили в официальный API OpenAI, открыли подписчикам корпоративного тарифа ChatGPT Work и предоставили владельцам рабочих пространств в Codex.
Для тех, кто пишет пайплайны процедурной генерации, настраивает шейдеры или собирает логику интерактивных сцен, восьмикратное ускорение меняет сам темп мышления. Когда креатор правит код генеративной графики или вручную тестирует гипотезы, длинный отклик убивает фокус. Режим Ultrafast спроектирован так, чтобы максимально сократить время на циклы правок, отладки и рутинного тестирования у разработчиков, вернув диалогу с машиной отзывчивость живого интерфейса.
Второй рубеж — автономные агентские сценарии. Сложные агенты редко варятся в собственном контексте: они регулярно запрашивают внешние базы, дергают сторонние сервисы, обращаются к графическим утилитам и сопоставляют результаты промежуточных итераций. Каждое такое действие порождает паузу между вызовами инструментов — так называемый tool use. Если цепочка ветвится на десятки шагов, выполнение задачи растягивается на минуты. Повышенная пропускная способность Ultrafast срезает эти межсервисные задержки, сшивая каскад запросов в единый непрерывный поток.
Архитектура Blackwell и самообучающийся стек
В основе ускорения лежит не просто наращивание кремния, а пересмотр того, как этот кремний распределяет задачи. Аппаратное обеспечение NVIDIA Blackwell и сопутствующий программный стек обладают сквозной программируемостью. Это означает, что одни и те же вычислительные мощности способны без трения переключаться между совершенно разными сценариями — тренировкой архитектур, непосредственным инференсом и обучением с подкреплением (reinforcement learning). Кластеры больше не простаивают в ожидании специфических задач.
Нас подкупила деталь из внутренней кухни разработчиков: специалисты OpenAI использовали собственные нейросетевые модели для оптимизации программного стека под кремний NVIDIA. Модели буквально отлаживали и дописывали софт для инференса, выжимая предельный КПД из чипов партнера. Руководитель направления инференса в OpenAI Филипп Тилле прямо объяснил логику этого шага: «Масштабные инвестиции NVIDIA в инструментарий и документацию позволили нам научить наши модели исключительно эффективно программировать графические процессоры Blackwell и Rubin».
Технический директор OpenAI по вычислительной инфраструктуре Удаи Руддарраджу рассматривает связку с чипами Blackwell как способ обуздать лавинообразные инфраструктурные затраты при росте аудитории. Чем быстрее модель отдает готовый ответ, тем меньше аппаратных ресурсов она связывает в моменте. Под эти задачи масштабируется и партнерская сеть: поставщики инфраструктуры вроде CoreWeave уже готовят мощности специально под тяжелые сценарии агентского искусственного интеллекта.
Публикация о запуске Ultrafast совпала с еще одним событием чипмейкера: стартовала регистрация на конференцию NVIDIA GTC Berlin, запланированную на 20–22 октября 2026 года. По-нашему, европейская площадка как раз станет витриной, где инженеры покажут поведение связки Blackwell и GPT-6 под реальной продакшен-нагрузкой в боевых средах.
Прагматизм этой интеграции радует: индустрия наконец переключилась с бесконечной гонки параметров на физическую скорость отклика. В креативном кодинге и автоматизации продакшена секунды ожидания всегда стоили дороже терафлопсов.