Google выпустила голосовые модели Gemini 3.8 Live, которые рассуждают вслух
Попросить голосового ассистента спланировать бюджетную поездку на выходные и получить не список сайтов, а готовый расчёт с датами и суммой — примерно так Google описывает разницу между обычным голосовым ботом и новым поколением своих моделей. Компания выпустила Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking — модели для голосового диалога, которые умеют рассуждать и одновременно не молчать.
Главная проблема голосовых ассистентов раньше была простой: чем сложнее задача, тем дольше пауза перед ответом, и разговор превращается в серию неловких зависаний. Extended Thinking решает это иначе — модель проговаривает промежуточные шаги вслух («сейчас проверю») и держит разговор живым, пока где-то в фоне довершает многошаговую задачу.
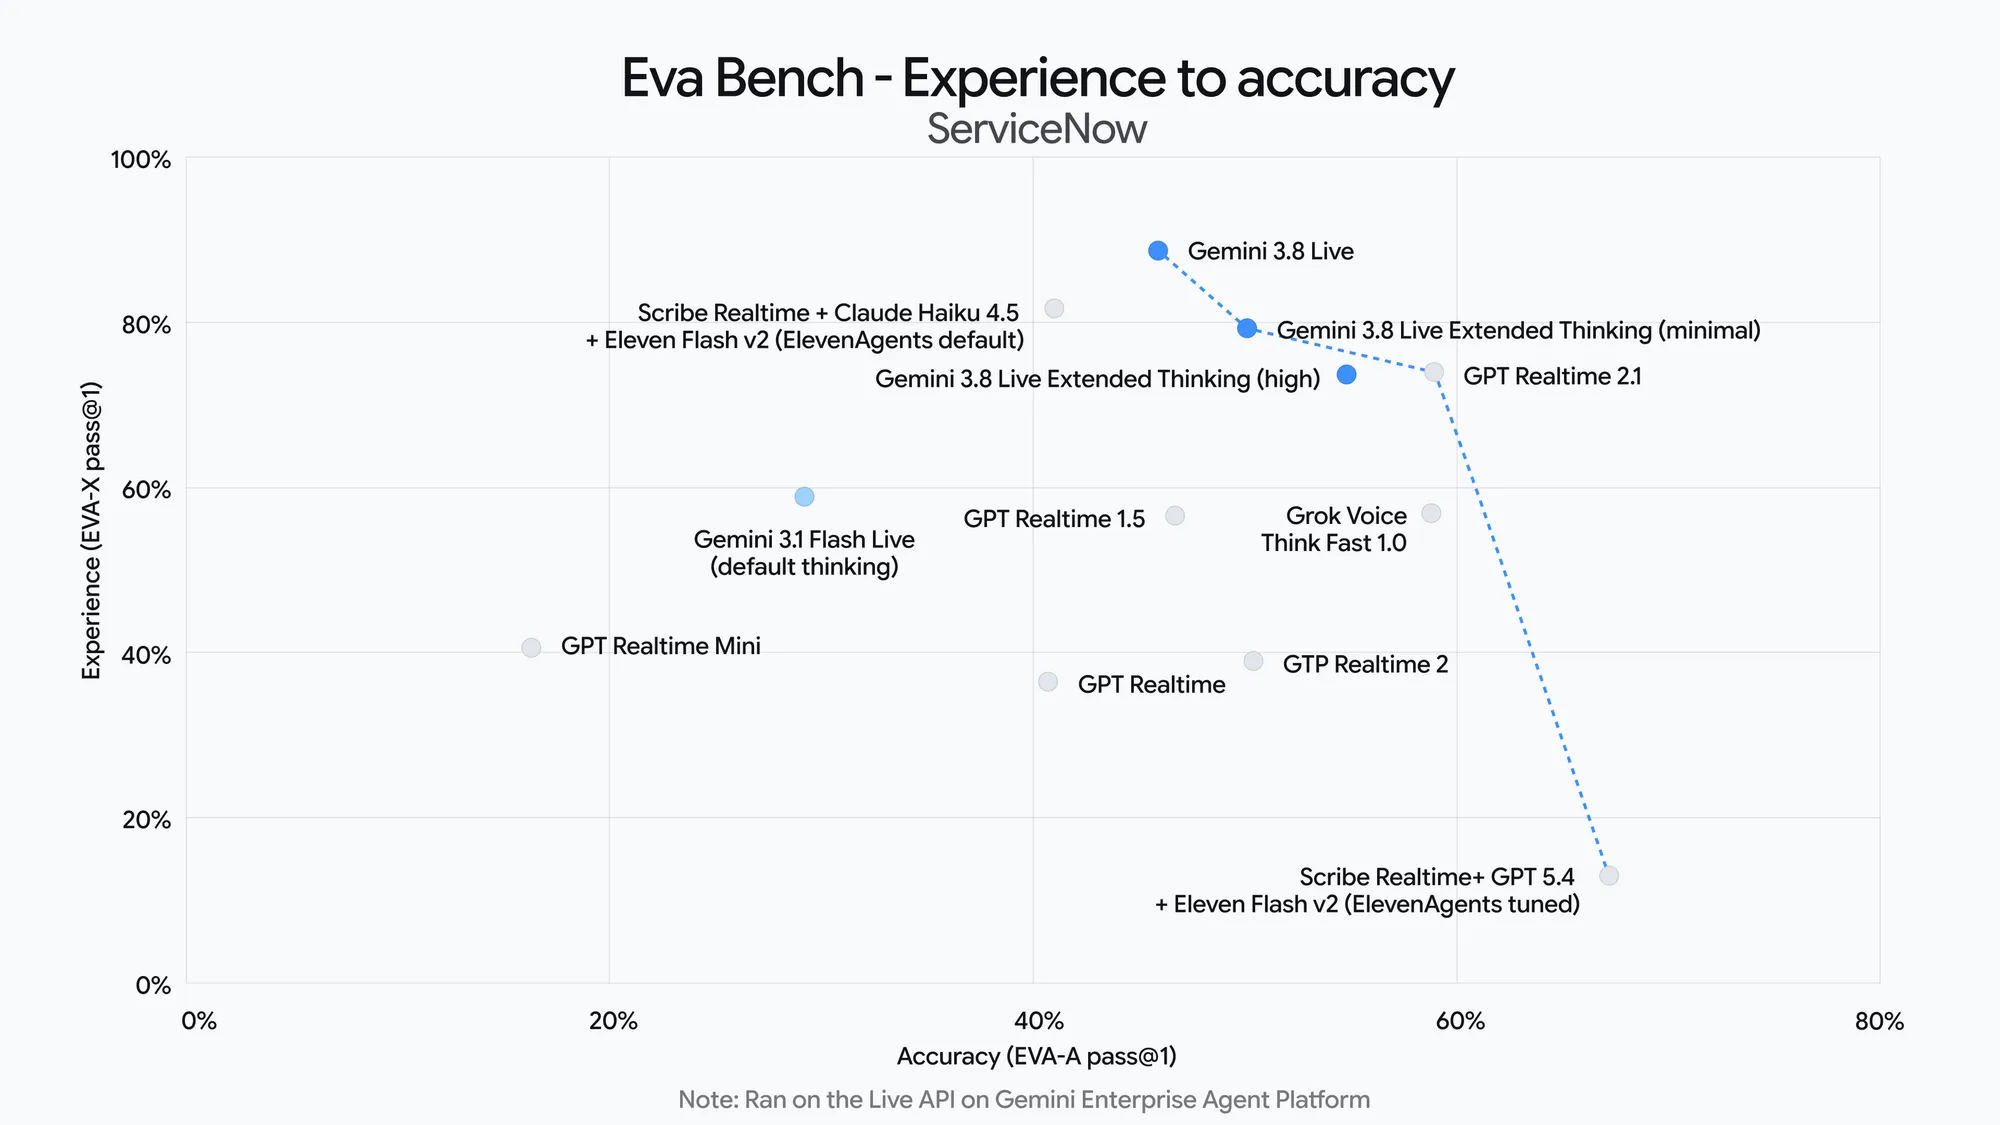
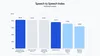
По независимым замерам Artificial Analysis, Extended Thinking заняла первое место в рейтинге качества «речь-в-речь» с результатом 82,6 балла, а на бенчмарке банковских сценариев Sierra — 35,1% успешных завершений задач. На Big Bench Audio, который проверяет рассуждение, модель показывает 97,7%. Обычная версия, Gemini 3.8 Live, заняла второе место в Speech Agent Arena — рейтинге предпочтений пользователей — и при этом остаётся заметно дешевле в использовании: она рассчитана на масштаб, а не на предельную сложность задач.
Обе модели различают визуальный контекст в реальном времени — то есть могут одновременно видеть, что происходит на экране пользователя, и разговаривать об этом. Тестовый пример от Google: модель ведёт партию в шахматы, комментируя ходы вслух и распознавая доску через камеру. Другой пример — Extended Thinking превращает набросок интерфейса от руки и голосовые правки в работающий React-компонент, объясняя вслух, что делает.
Ещё одна деталь, которая обычно остаётся незамеченной в демо-роликах: модели умеют на лету переключаться между 97 языками прямо посреди разговора и запускать инструменты или API-вызовы в фоне, не прерывая беседу. То есть пока модель обещает «сейчас закажу столик», бронирование действительно происходит — и пользователь может продолжать разговор о чём-то другом.
Обе модели уже доступны: разработчикам — через Gemini API и Google AI Studio, компаниям — в закрытом раннем доступе в Gemini Enterprise, а обычным пользователям Extended Thinking приходит в Gemini Live и подписчикам Google AI Pro и Ultra — в Docs, Gmail и Keep внутри Workspace. Обычная Live-версия доступна всем в режиме Search Live. Среди компаний, уже опробовавших модели в проде — Salesforce, Genspark и Lumeris, а голосовые платформы вроде LiveKit и Pipecat уже встраивают новые модели в свои продукты.
Весь звук, сгенерированный моделями, помечен невидимой меткой SynthID — Google заранее подстилает соломку на случай, если синтетический голос станет неотличим от настоящего. Судя по тому, как модель ведёт партию в шахматы, глядя в камеру, эта предосторожность выглядит не лишней.