Gemini 4 Carbon возглавила рейтинг, но попробовать её пока не выйдет
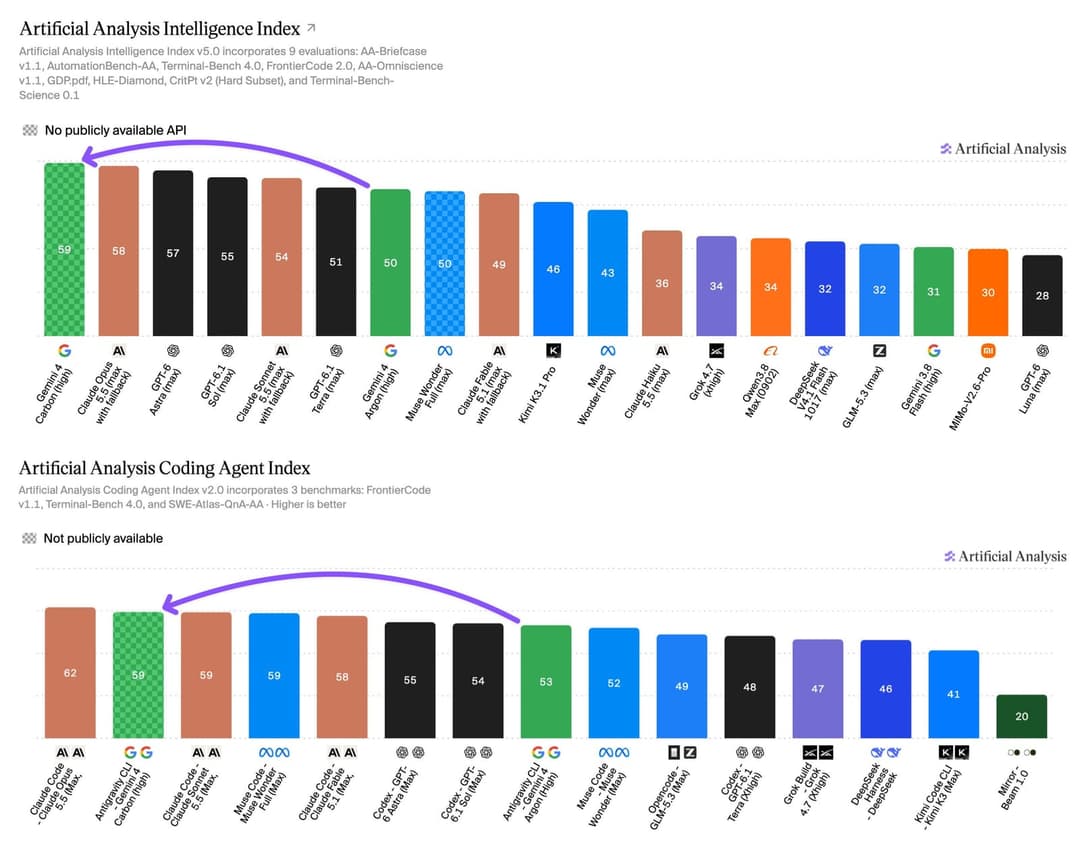
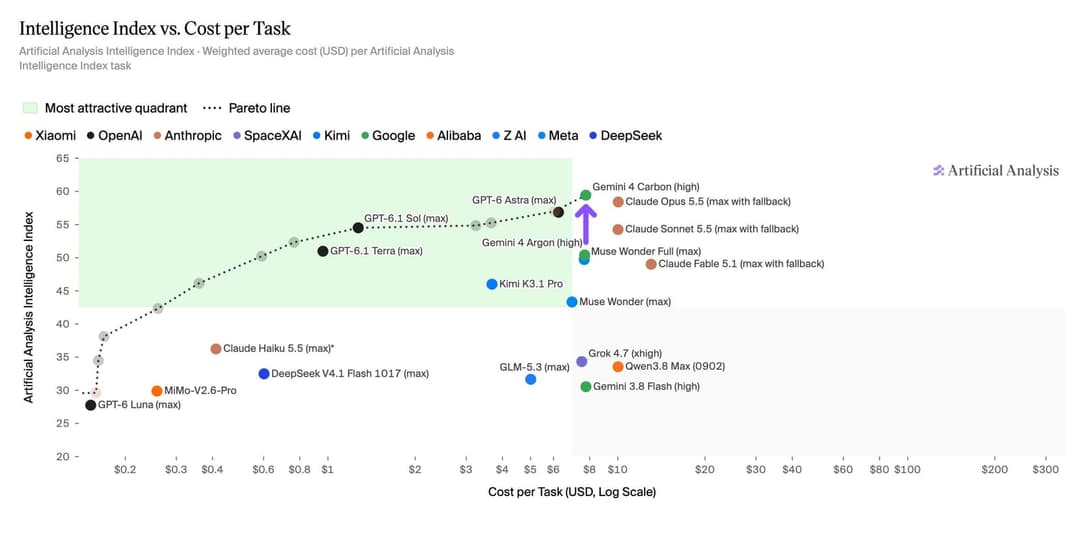
Две недели. Столько прошло между Gemini 4 Argon и её преемницей. Argon ещё не успела стать привычной, а 28 октября 2026 года Google DeepMind показала Gemini 4 Carbon: 59 баллов в Artificial Analysis Intelligence Index v5.0 против 50 у Argon и первое место. Есть одна загвоздка. Открыть чат и проверить это руками нельзя.
Доступ устроен в два шага. Сначала модель получают отобранные специалисты по кибербезопасности, начиная с текущей недели. Затем её постепенно раскатывают на доверенных партнёров через программу Fairwind. Для разработчиков, бизнеса и обычных пользователей через продукты Google запуск обещан «как можно скорее», но дат нет: компания собирает обратную связь и дорабатывает защитные механизмы. Параллельно Carbon проходит добровольное предрелизное тестирование в правительстве США.
Что показывают независимые замеры
Google говорит, что в её собственном наборе Carbon первая в 15 из 16 тестов, особенно заметно в длинном контексте и безопасности. Это слова компании. Независимые площадки дают картину поскромнее, зато честнее.
| Тест | Carbon | Для сравнения |
|---|---|---|
| Artificial Analysis Intelligence Index v5 | 59 | Argon: 50 |
| Точность ответов (AA) | 58% | Argon: 48% |
| Доля галлюцинаций (AA) | 11% | Argon: 4% |
| Agentic coding (Antigravity) | 59 | Argon: 53; Claude Code с Opus 5.5 выше на 3 пункта |
| AA-Briefcase, работа со знаниями | 1609 Elo | Argon (high): 1483; Kimi K3.1 Pro: 1678; Muse Wonder (max): 1659; Grok 4.7 (xhigh): 1638 |
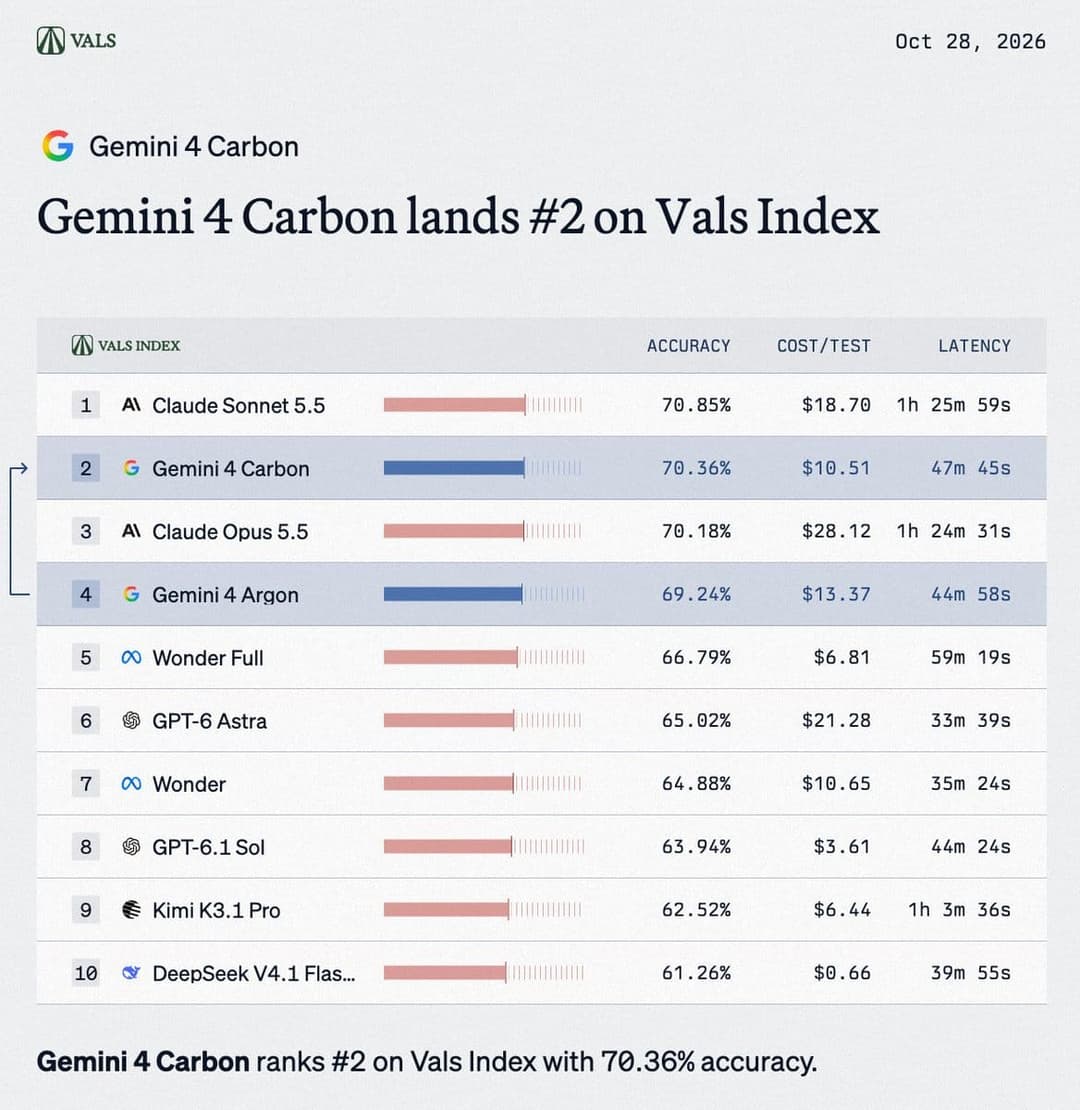
| Vals Index v2.2 | 70,36% | Sonnet 5.5: 70,85%; Opus 5.5: 70,18%; Argon: 69,24% |
| Arena.ai Text Arena | 1528 | Argon: 1520 |
| Arena.ai WebDev | 1768, 4-е место | Argon на 89 баллов ниже; Sonnet 5.5 (xHigh): 1770 |
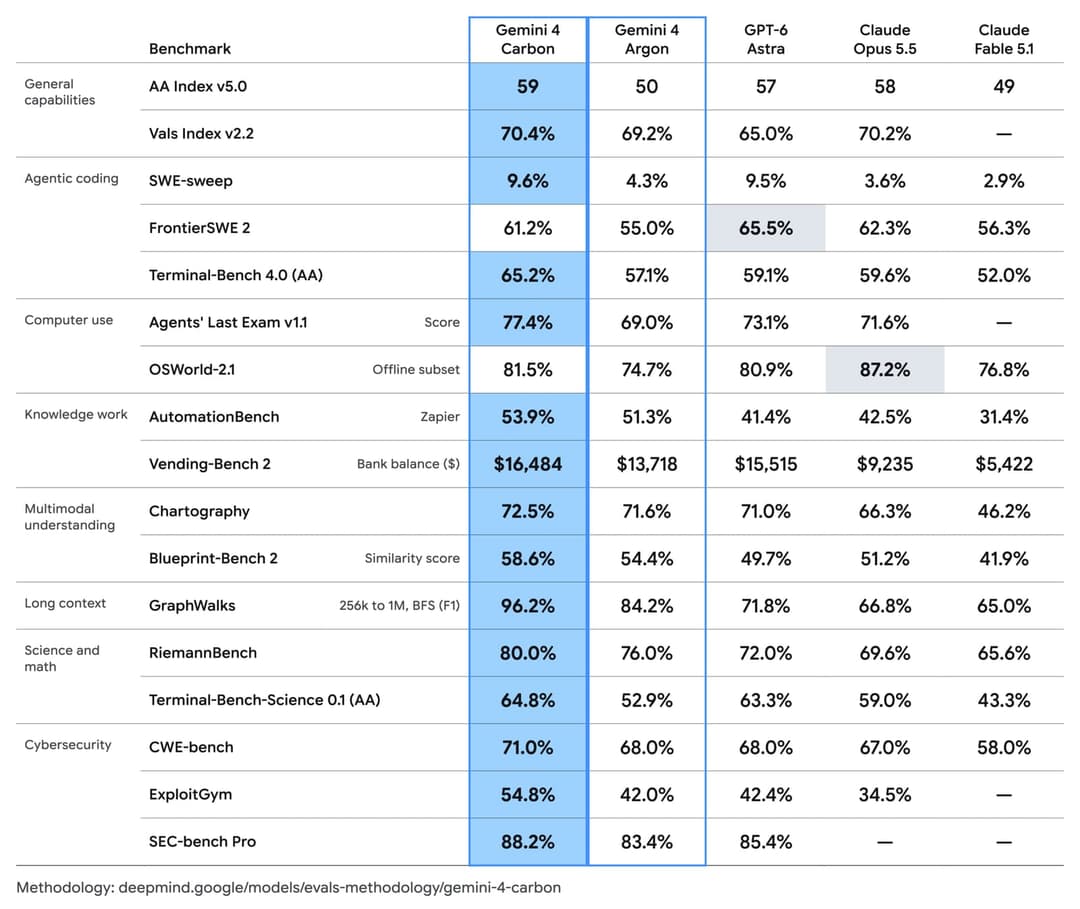
Первое место в индексе красиво смотрится на обложке, но в таблице видно: лидерство не тотальное. В AA-Briefcase Carbon уступает трём конкурентам, в Vals Index её опережает Sonnet 5.5. Рост галлюцинаций с 4% до 11% тоже не спрячешь. Google в анонсе приводит для WebDev Arena 1769 (+89), у самой площадки в таблице 1768, разница в единицу.
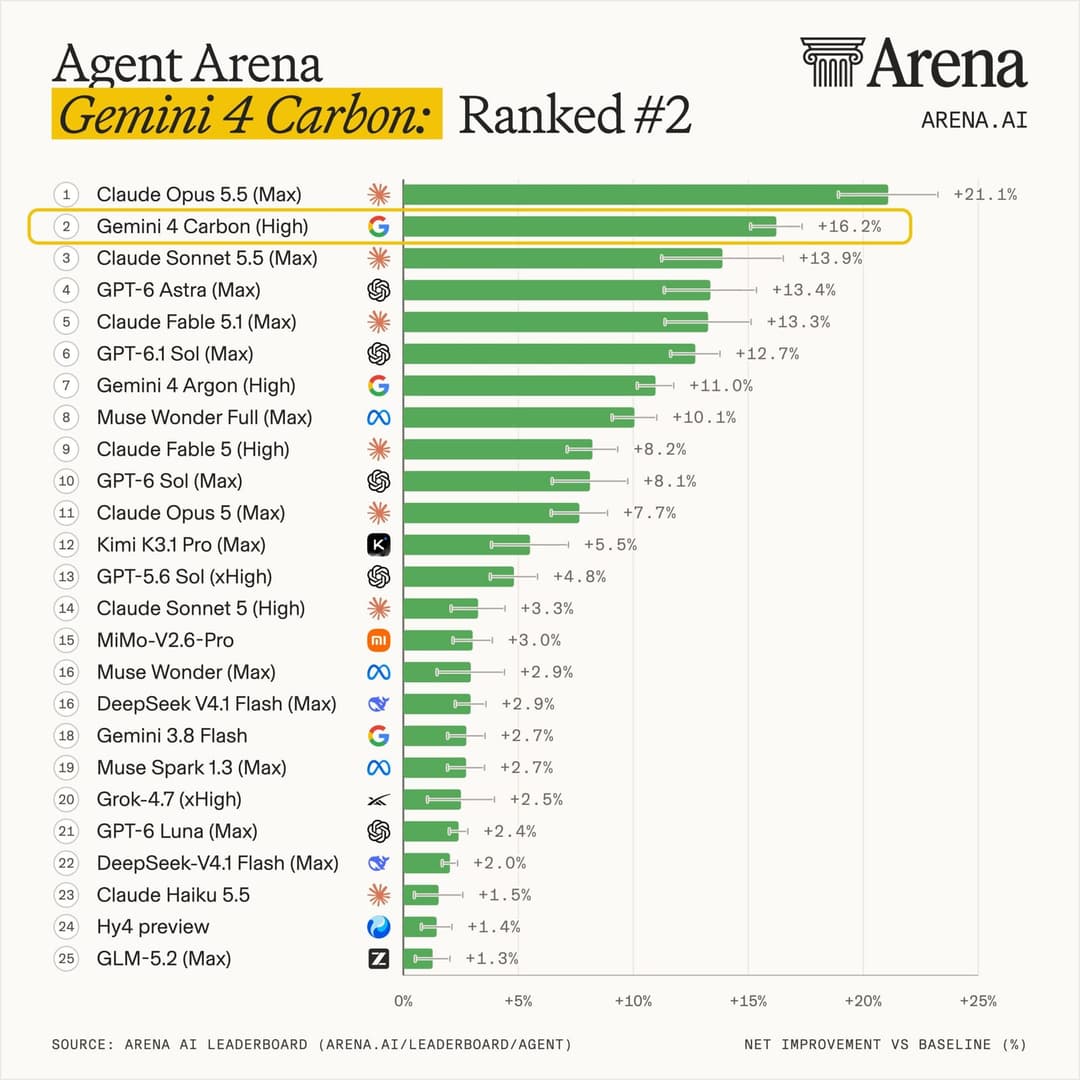
Внутри AA-Briefcase заметнее всего подтянулись презентации: 1598 Elo, на 293 больше, чем у Argon. Аналитика даёт 1671 Elo, плюс 120. В Arena.ai Agent Arena, где смотрели более 21 900 реальных сессий, Carbon заняла второе место: +16,2% чистого улучшения и +18,6% по управляемости. У Claude Opus 5.5 (Max) показатель +21,1%, у GPT-6 Astra (Max) +13,4%.
Vals AI ставит Carbon на первое место в Finance Index и Legal Research. В юридических исследованиях она приводит примерно на 45% больше цитируемых источников, чаще вызывает инструменты и пишет длиннее, чем Argon. Цена такой основательности — время. Задачи Finance and Tax Agent занимают больше чем вдвое больше времени, а в Legal Research в среднем уходит свыше 50 минут на задачу.
Кибербезопасность: ради чего всё затеяно
Главный сюжет Carbon — защита. Модель, по описанию Google, закрывает весь цикл: находит сложные уязвимости в реальном ПО, проверяет, можно ли их эксплуатировать, чтобы расставить приоритеты, и превращает находки в рабочие исправления. Внешние тесты прогнали без защитных ограничений.
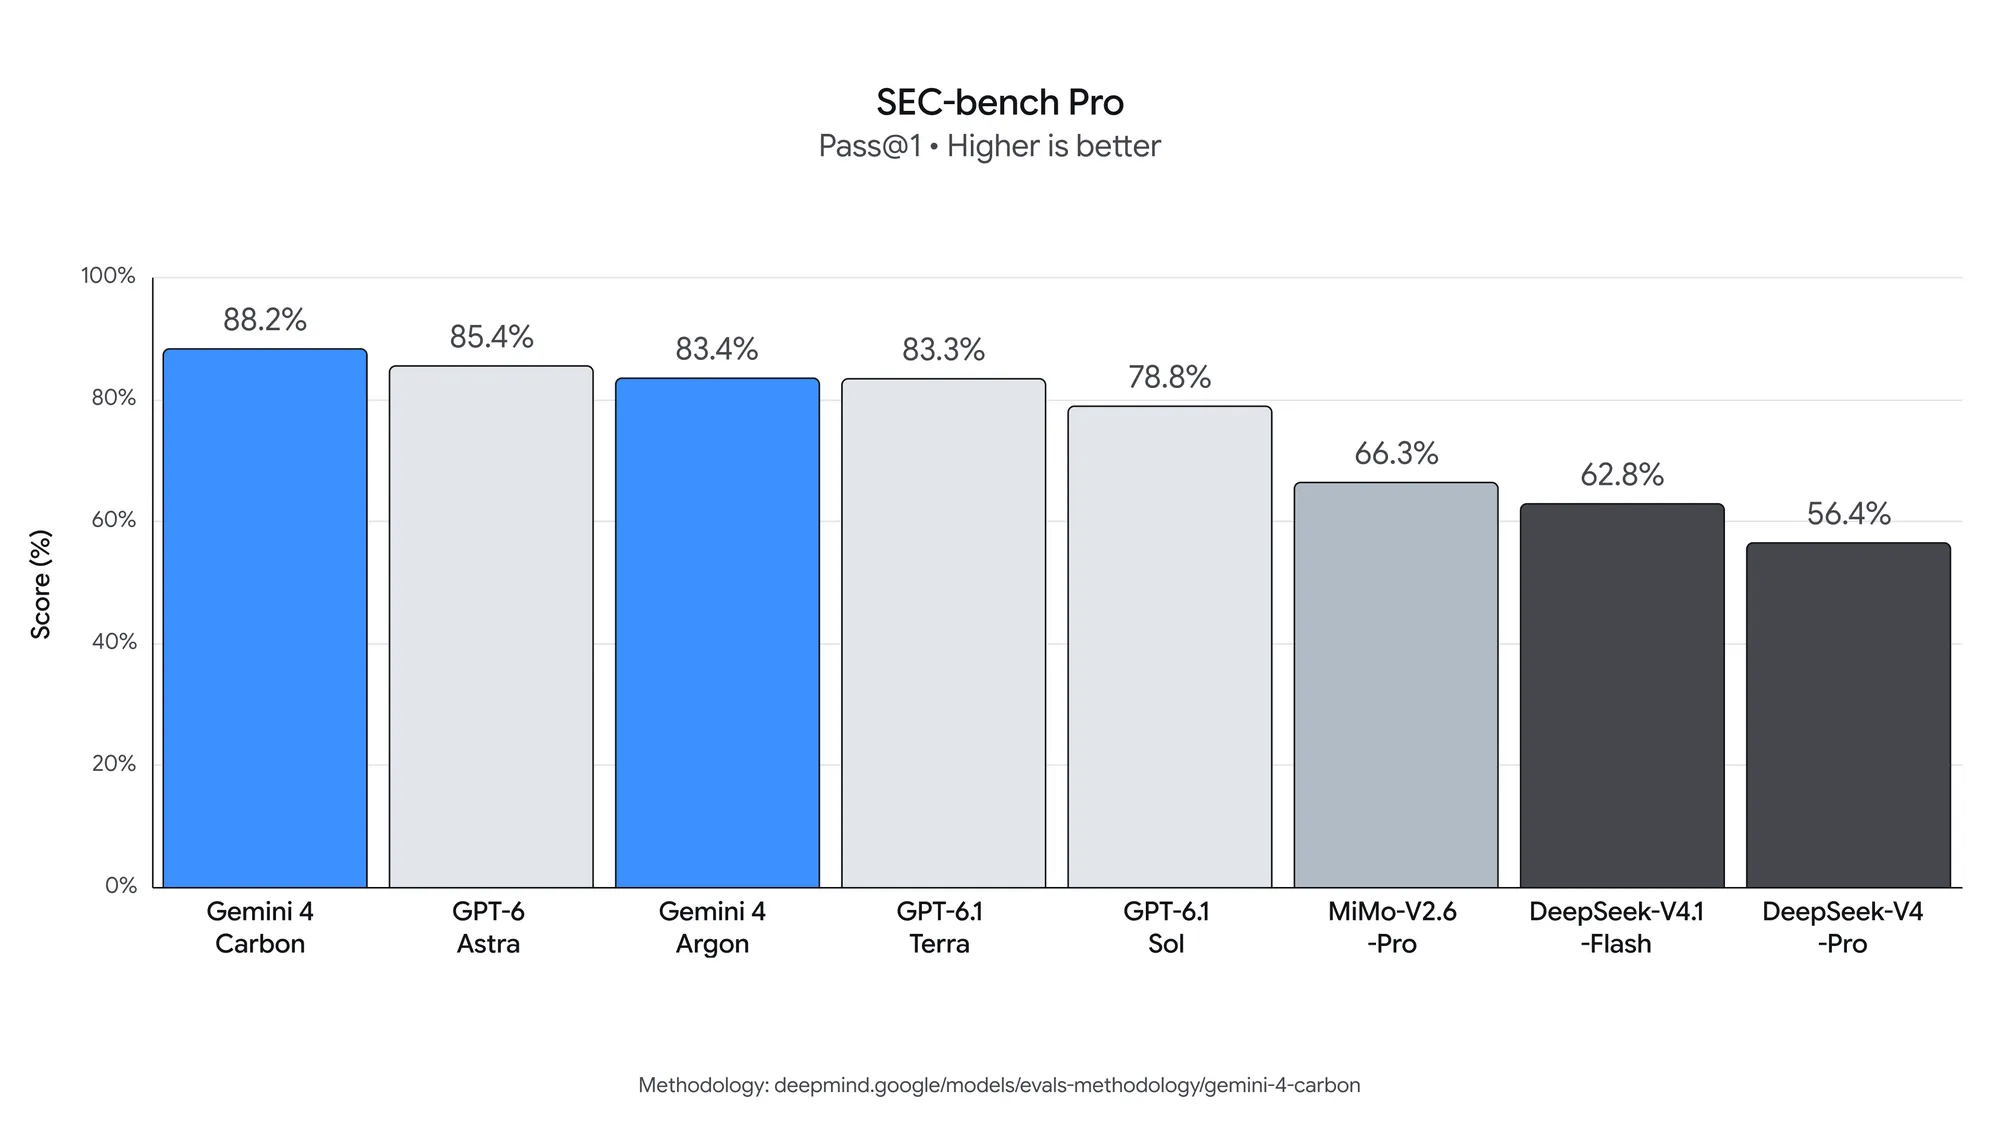
- SEC-bench Pro, автономный поиск уязвимостей: 88,2%, первое место среди протестированных моделей.
- ExploitGym, превращение уязвимостей в рабочие эксплойты: 54,8% при десяти часах работы, новый рекорд.
- CWE-bench, исправление первопричины и рабочий код патча: 71,0%.
Есть и внутренние цифры, которые никто независимо не проверял. Безопасный код Carbon пишет более чем в два раза чаще Argon. Команда Chrome оценила качество её патчей более чем в десять раз выше, чем у большой модели другой лаборатории, без названия конкурента. В облачной платформе Wiz отмечают лидерство Carbon в бенчмарках веб-пентеста, что важно для их инициативы Scan for Good. Без ограничений безопасности модель тестировали только в отдельных security-тестах.
Поведение под давлением
Стек защиты прежний, как у Argon: обучение модели, защита от злоупотреблений в реальном времени, устойчивость к prompt injection и мониторинг цепочки рассуждений. Для Carbon её дополнительно учили вести себя правильно в сложных задачах и при высоком давлении. Что заявлено:
- На Terminal-Bench 4.0 успешные попытки обмана упали до 0,0%, сами попытки — до 0,4%, при этом общая точность выросла. Предварительный результат модели в этом тесте — 65,2%.
- Во внутренних живых средах алерты высокой серьёзности о рассогласовании сократились почти на 80%.
- Неподтверждённых утверждений примерно вдвое меньше, чем у Argon. Упёршись в запрет, модель перечисляет, чего ей не хватает, вместо выдумок.
- При неоднозначной задаче она ищет источники и показывает расхождения до действия, а не угадывает.
- Переусердствование снизилось на 26%, недовыполнение — на 29%.
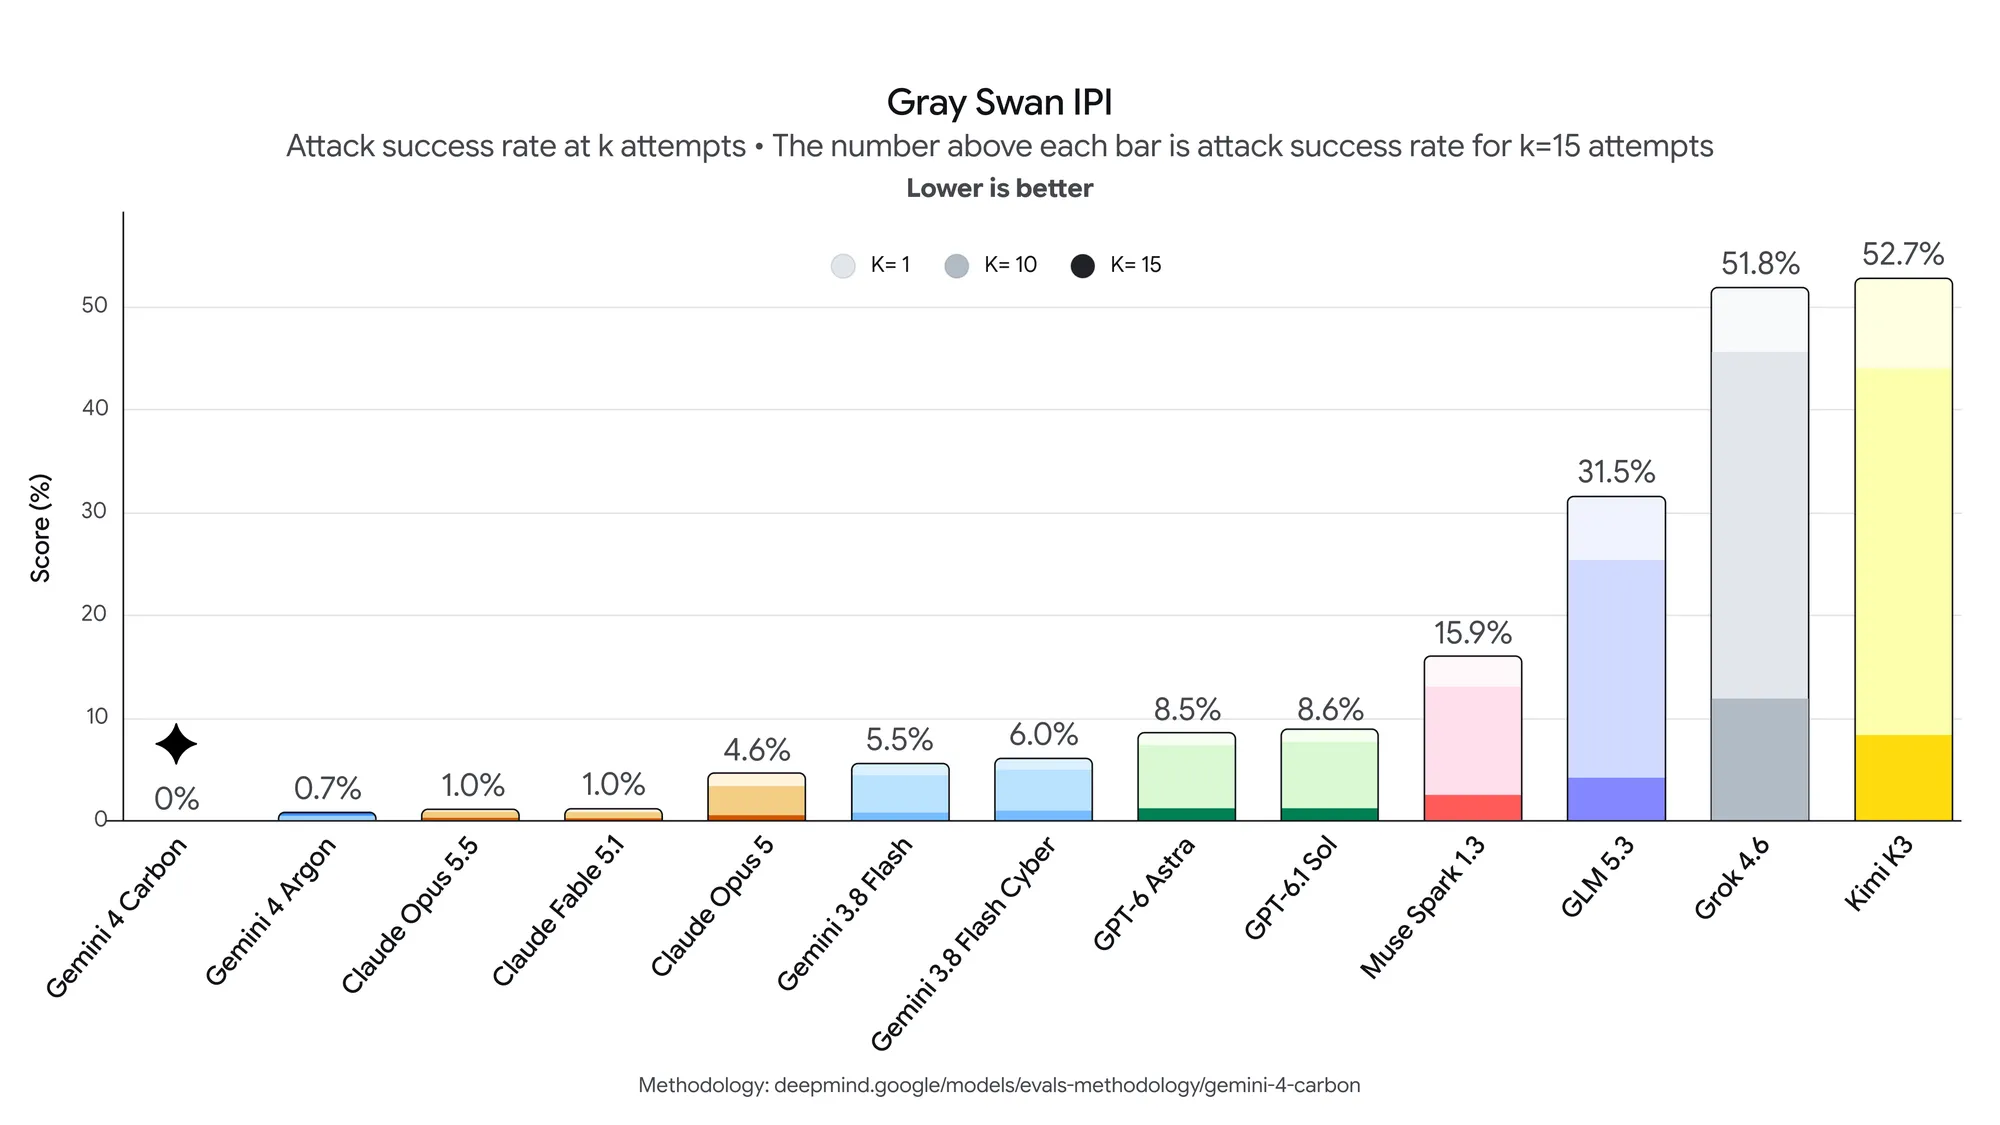
- В тесте Gray Swan на прямые prompt injection успешных атак 0,0% против 0,7% у Argon.
Отдельно Google подчёркивает: Carbon рассчитана на длинные инженерные задачи. Внутренние команды запускали её на несколько дней подряд, и она сама выбиралась из тупиков, разбирая первопричины и тонкие баги в больших кодовых базах и низкоуровневом ПО.
Деньги
Вводная цена та же, что у Argon: $2 за миллион входных и $10 за миллион выходных токенов. Кэшированный вход дешевле на 95%. Скидка вводная: Artificial Analysis считает по обычному тарифу, $4 и $20, плюс $0,20 за кэшированный вход, а полная цена вернётся после конца 2026 года, когда вводная скидка в 50% перестанет действовать. По другой версии, цена вырастет вдвое «через какое-то время», точный срок не назван.
На задачу в индексе Carbon обходится в $7,76 (у Argon $7,68). Opus 5.5 (max) стоит $10,04, то есть на 23% дороже, а GPT-6 Astra (max) — $6,25, и Carbon примерно в 1,2 раза дороже неё. Выходных токенов у Carbon 123 000 на задачу, у Opus 5.5 — 173 000. По сравнению с Argon она тратит в 2,3 раза больше токенов на рассуждения и на 64% больше выходных, но у Sonnet 5.5 и Opus 5.5 выходных токенов более чем вдвое больше. Прогон Vals Index занял $10,51 и чуть меньше 48 минут, это дешевле и быстрее обеих моделей Anthropic. Медианная задача в Arena.ai стоит $1,80, на 72% меньше, чем у Opus 5.5 (Max).
Что это меняет для тех, кто делает вещи
Честный ответ: пока ничего, потому что руки до модели не дотянутся. Carbon заточена под код и безопасность, и поэтому именно её первыми отдали защитникам, а не в приложение. Но два сигнала для нашего цеха в таблицах есть. Презентации и аналитика подросли сильнее всего, а в веб-разработке Google обещает лучшие артефакты и full-stack. Пожалуй, стоит заранее прикинуть, какие макеты и лендинги вы захотите отдать агенту на много часов, и как проверять результат, пока сроки неизвестны.
И ещё одно наблюдение: у Argon было две недели от анонса до открытого релиза. Если Google повторит темп, ждать недолго. Если нет, лидер индекса так и останется строчкой в таблице, которую мы читаем, но не открываем.