ElevenLabs выпустила Scribe v2 Medical для распознавания медицинской речи
Медицинский диктант — один из самых недружелюбных тестов для распознавания речи: названия препаратов длинные, редкие и легко путаются на слух (гидроксизин и гидралазин отличаются одним слогом), а дозировки, единицы измерения и анатомические термины сыплются подряд. Цена ошибки здесь не «неловкая опечатка», а строчка, которая может попасть в карту пациента.
ElevenLabs вывела в общий доступ Scribe v2 Medical — версию своей модели распознавания речи, дообученную специально на клинических записях. Модель доступна в ElevenAPI и снижает долю ошибок (WER) на медицинском аудио примерно на 35% по сравнению с базовой Scribe v2.
Что показали тесты
На бенчмарке MedDictate от компании Corti, где модели транскрибируют диктовку клинических заметок на английском, французском и немецком, Scribe v2 Medical показала самый низкий общий уровень ошибок среди всех протестированных систем — включая GPT Transcribe от OpenAI, Deepgram Nova-3 Medical и голосовую модель Muse Voice Transcribe 1.0.
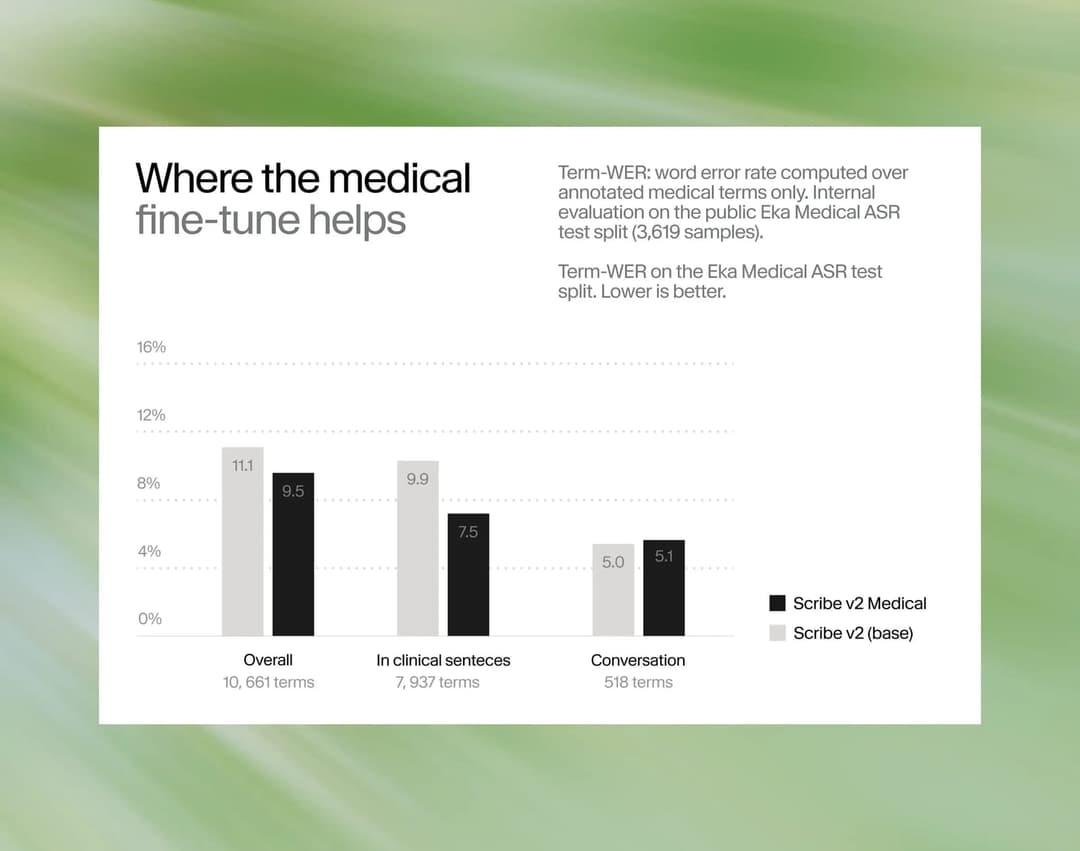
На отдельном бенчмарке медицинской терминологии MedTerm модель лидирует сразу по двум параметрам во всех трёх языках — полнота распознавания терминов и точность их транскрибирования — и обходит по обоим показателям всех конкурентов. А на бенчмарке Eka Medical ASR, где собрано 3619 клинических аудиозаписей на английском, Scribe v2 Medical делает на 15% меньше ошибок на медицинских терминах, чем базовая версия, и разрыв особенно заметен, когда термин звучит внутри полноценного клинического предложения, а не отдельным словом.
Кстати, про отдельные слова: изолированные названия препаратов без контекста остаются самым сложным случаем для любой модели, включая эту — 14,3% ошибок против 7,5% в составе предложения. Снизить такие промахи помогает функция keyterm prompting: можно заранее подсветить модели список нужных препаратов и терминов, чтобы она не гадала вслепую.
Один из клиентов, сервис CareCo, перешёл на Scribe v2 Medical с Deepgram и, по словам основателя компании Менделя Эрленвейна, стал заметно точнее распознавать терминологию — координаторы тратят меньше времени на правку заметок и больше на разговоры с пациентами. При этом на обычной, немедицинской речи модель не потеряла в качестве: на 6000 образцов повседневных фраз она показала тот же уровень ошибок, что и базовая версия, — 5,3%.
Для корпоративных клиентов с соглашением о защите данных модель доступна в режиме, совместимом с HIPAA, и с нулевым удержанием данных: аудио и текст удаляются сразу после обработки запроса. Подключить модель можно, просто указав её идентификатор в Speech to Text API.