ElevenLabs выпустила Eleven v4 с человеческими эмоциями и реакцией за 150 миллисекунд
Десятисекундного голосового сообщения из мессенджера теперь достаточно, чтобы нейросеть заговорила вашим голосом на девяноста с лишним языках, причем без характерного металлического звона в связках. ElevenLabs представила новое поколение синтеза речи — флагманскую архитектуру Eleven v4 и ее скоростную версию Eleven v4 Turbo. Если прежние итерации генераторов часто спотыкались на длинных дистанциях и звучали монотонно, то здесь упор сделан на то, ради чего обычно нанимают живых актеров дубляжа: спонтанный смех, шепот, драматические паузы и способность удерживать темп сцены.
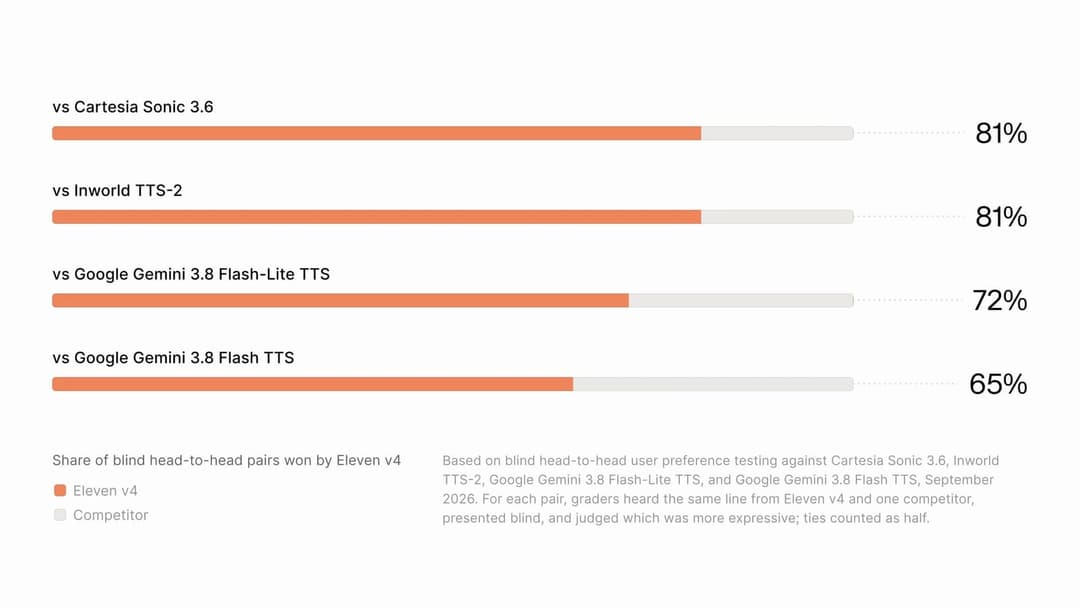
В слепых А/Б-тестах слушатели отдают предпочтение новинке примерно в 75% случаев. По состоянию на сентябрь 2026 года модель удерживает верхнюю строчку в рейтинге Provider Voice Arena на платформе Artificial Analysis. Алгоритм напрямую сравнивали с ближайшими соперниками по цеху — Cartesia Sonic 3.6, Inworld TTS-2, а также Google Gemini 3.8 Flash TTS и ее облегченной версией Flash-Lite TTS. Разрыв оказался ощутимым именно в тонких интонациях: там, где конкуренты скатываются в ровное дикторское чтение, v4 подстраивается под эмоциональный градус текста.
Режиссура через текстовые теги
Главное техническое новшество для тех, кто собирает звук руками, — расширенная поддержка инлайн-разметки прямо в теле сценария. Теперь не нужно резать дорожку на куски и прогонять через сторонние плагины каждый вздох. Достаточно прописать в скобках нужную эмоцию или звуковой эффект, и система встроит их бесшовно. В генерацию можно зашивать:
- Эмоциональные модификаторы и поведение: например, [laughs] для естественного смешка посреди фразы или [said angrily in French accent] для резкой смены настроения и манеры подачи;
- Фоновые шумы и интершум: теги вроде [phone buzzing] или [light rain] генерируют акустическое окружение одновременно с голосом;
- Фонетическую разметку: глубокая интеграция с Международным фонетическим алфавитом (IPA) позволяет жестко фиксировать произношение сложных фамилий, выдуманных терминов и редких топонимов без шаманства с транскрипцией.
Отдельно пересобрали логику многоголосых сцен. Раньше при озвучке диалогов или аудиокниг реплики разных персонажей часто звучали оторванно друг от друга. Eleven v4 учитывает общий контекст происходящего: персонаж повышает голос в ответ на раздражение собеседника или переходит на доверительный полушепот, если сцена стала камерной. При этом алгоритм склейки запросов (request stitching) избавил длинные аудиодорожки от внезапных перепадов громкости и тембра, что упрощает работу в ElevenLabs Studio и ElevenLabs Reader App.
Скорость для живых сценариев
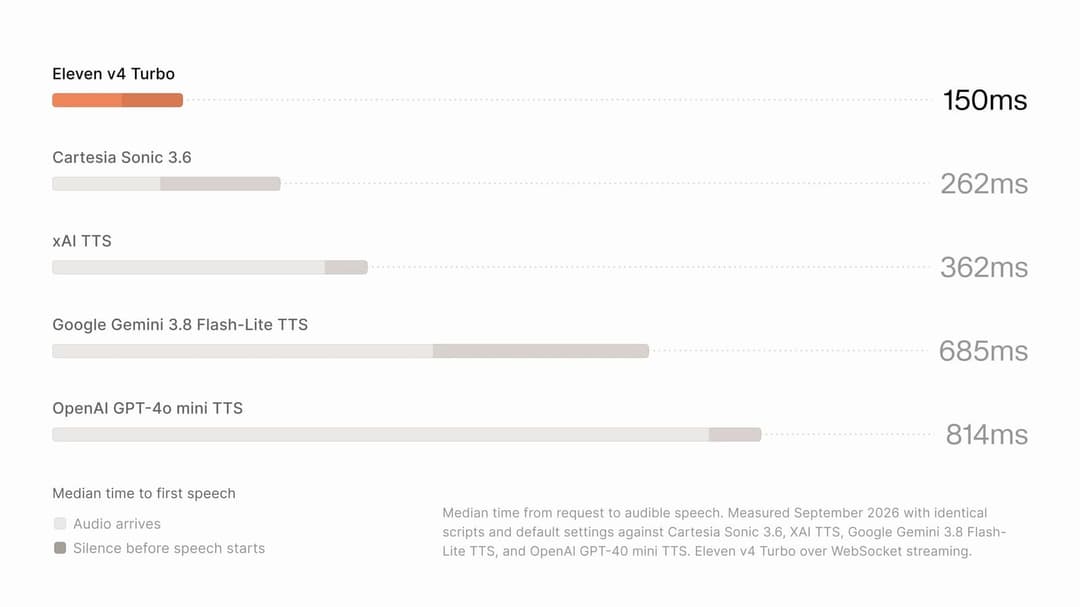
Параллельно с тяжелой базовой версией вышла Eleven v4 Turbo, созданная под голосовых ассистентов и интерактивные инсталляции. В связке с протоколом WebSocket задержка от отправки текстового промпта до первого звука речи (Time to First Speech) составляет всего около 150 мс, а медианная задержка инференса держится на уровне 100 мс. В сравнительных замерах сентября 2026 года при равных условиях тестирования модель сопоставляли с главными быстрыми движками рынка.
| Движок синтеза речи | Назначение и контекст замера |
|---|---|
| Eleven v4 Turbo | Задержка до первого звука ~150 мс, инференс ~100 мс |
| Cartesia Sonic 3.6 | Сравнительный тест скорости WebSocket |
| xAI TTS | Сравнительный тест скорости WebSocket |
| Google Gemini 3.8 Flash-Lite TTS | Сравнительный тест скорости WebSocket |
| OpenAI GPT-4o mini TTS | Сравнительный тест скорости WebSocket |
В вопросах дубляжа исчезла старая проблема локализации: голос, исходно записанный на русском или английском, теперь свободно ведет диалог на любом из более чем 90 доступных языков. Нейросеть сохраняет индивидуальный тембр и манеру речи, но воспроизводит произношение целевого языка без паразитного родного акцента на протяжении всего дубля. Инструментарий клонирования сохранил два привычных формата: мгновенные цифровые слепки Instant Voice Clones по 10-секундному сэмплу и тяжелые профессиональные профили Professional Voice Clones (PVC) для брендовых проектов.
Оба релиза уже доступны через платформы ElevenAgents, ElevenCreative и напрямую через ElevenAPI. Для моушн-дизайнеров и креативных команд это означает простую вещь: драфтовая озвучка аниматиков и рекламных шотов наконец перестает звучать как голосовой помощник из дешевого навигатора. Режиссировать интонации диктора теперь можно прямо в текстовом поле, не дожидаясь ночной смены звукорежиссера.