Cognition принесла в Devin систему из двух моделей, снижающую цену кодинга на 39%
Обычный способ сэкономить на дорогой модели — роутинг: простые задачи отдать дешёвой нейросети, сложные — дорогой. Проблема в том, что по первому промпту не всегда понятно, простая задача или нет: «почини баг xyz» может оказаться правкой на одну строку, а может — переписыванием половины архитектуры. Команда Cognition, разработчик кодового агента Devin, предложила решение без угадывания: гонять не одну модель, а сразу две параллельно.
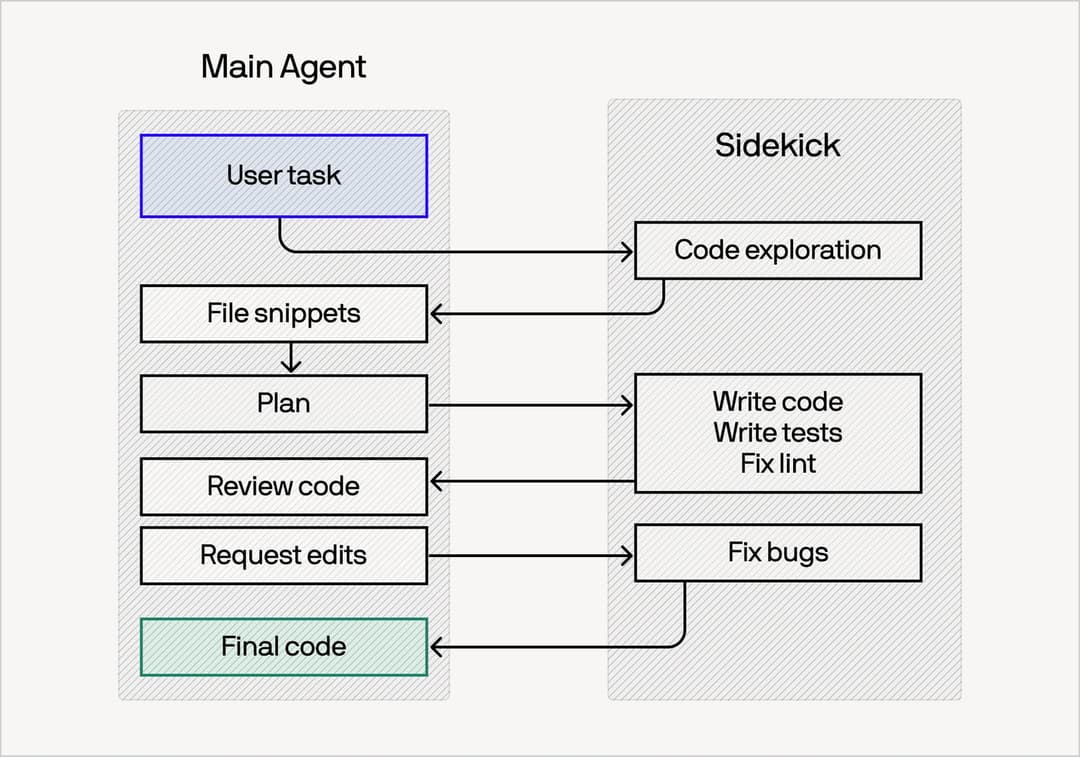
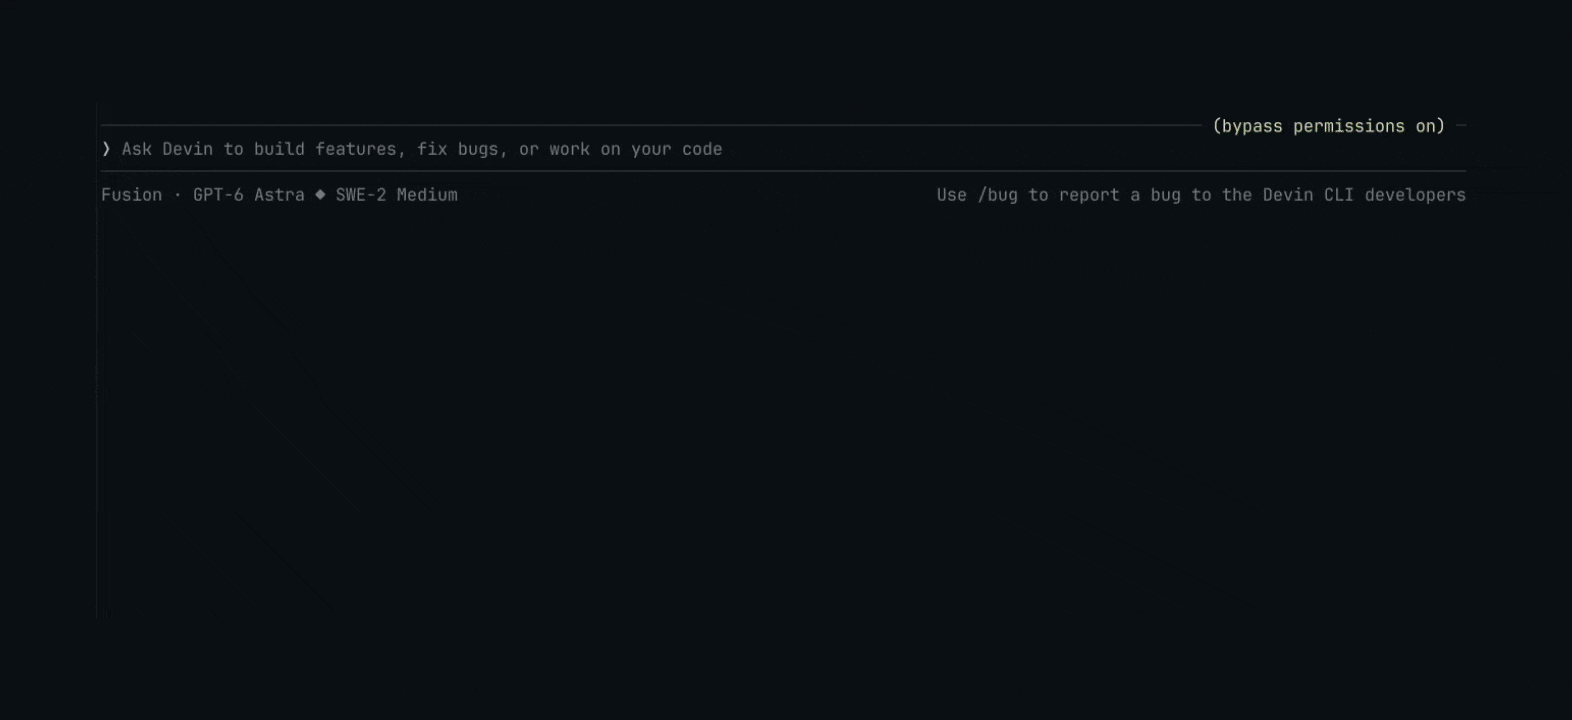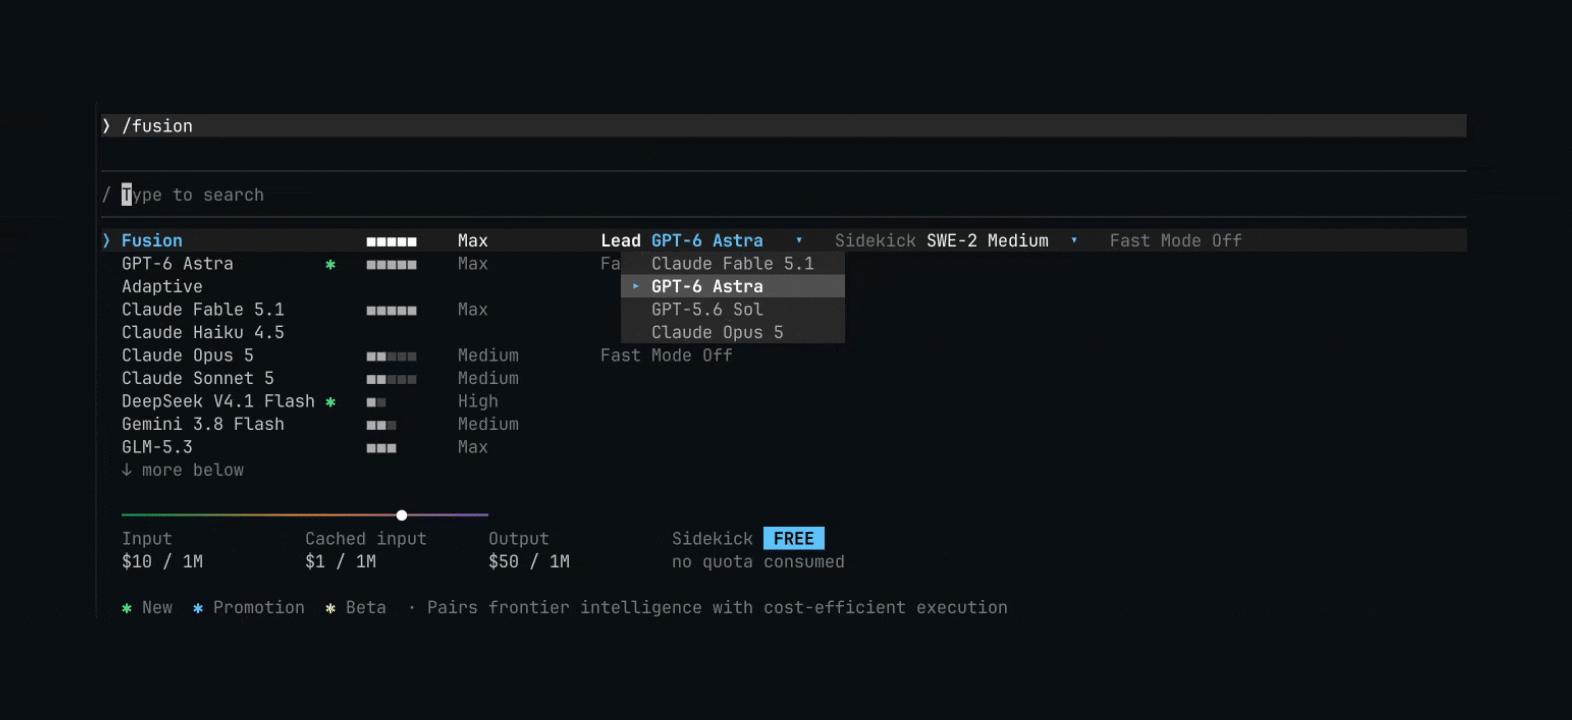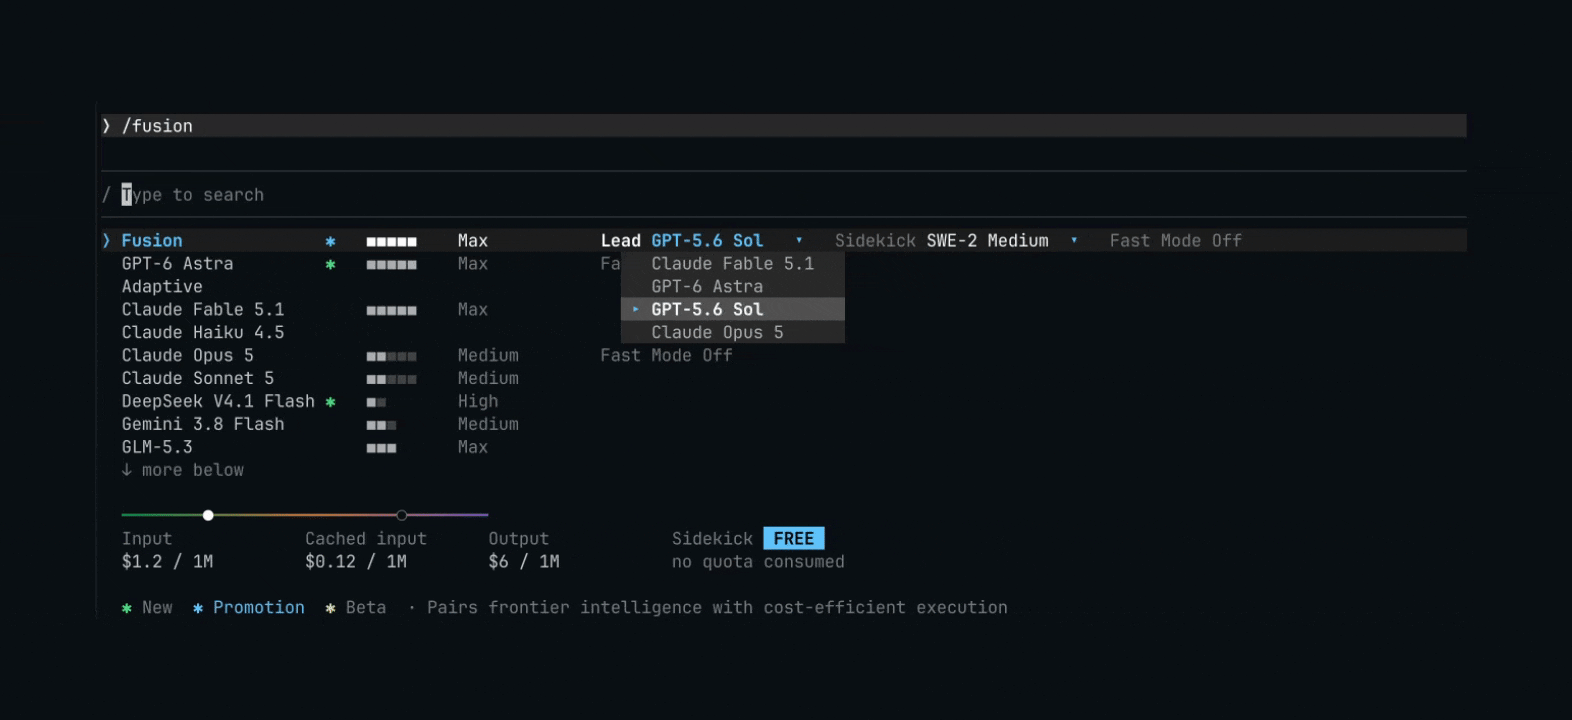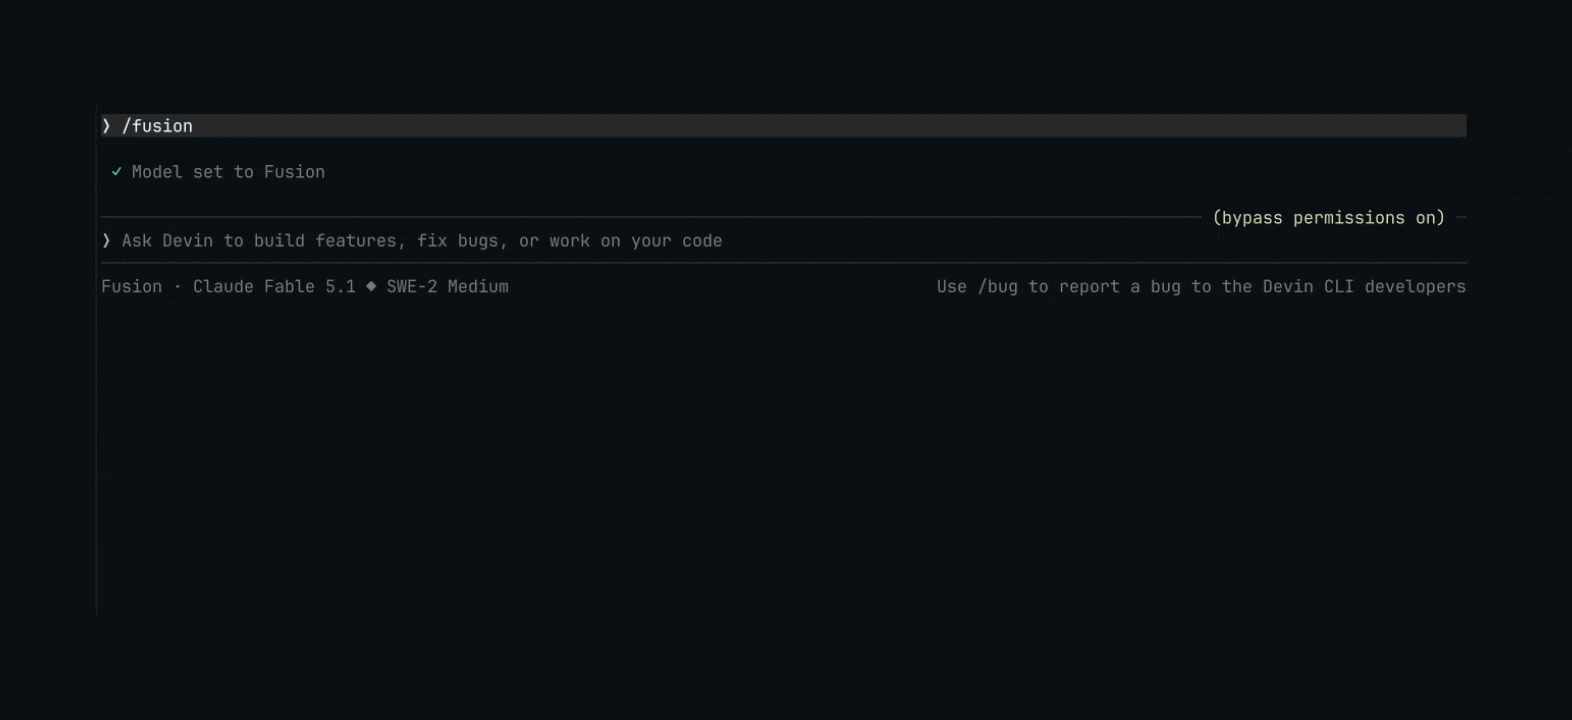
Технология называется Fusion, и раньше она работала только в облачной версии Devin — теперь доступна в десктопном приложении и командной строке. Идея простая на словах: пользователь выбирает не одну модель, а пару — «ведущую», которая занимается планированием и проверкой, и «напарника», подешевле, который выполняет черновую работу. Рекомендуемая связка — модель Fable 5.1 в роли ведущей и SWE-2 в роли напарника.
Разница с обычным роутингом в том, что обе модели работают одновременно, каждая со своим постоянным контекстом. Ведущая модель владеет планом и решает спорные моменты, передавая напарнику задачи с чёткими рамками и критериями успеха. Напарник исследует код, вносит правки, гоняет тесты и отчитывается — а между моделями передаются не целые переписки, а только краткие брифы и результаты. Это позволяет обеим моделям пользоваться кэшированием промптов на полную, чего роутинг не даёт в принципе: смена модели посреди задачи ломает кэш и превращается в лишние расходы.
По независимым замерам Artificial Analysis и Vals AI, связка Fable 5.1 с напарником SWE-2 обходится дешевле топовой модели без напарника на 39% при сравнимом качестве, а на отдельных бенчмарках экономия доходит до 46%. При этом ведущая модель всегда проверяет работу напарника и может забрать управление обратно, если тот не справляется — то есть пользователь всегда общается с топовой моделью, а не с её урезанной версией.
Самое неожиданное открытие команды: более дорогая модель иногда делает всю систему дешевле, а не дороже. Когда Cognition заменила модель Opus 4.8 на Fable 5 в роли ведущей — а Fable стоит вдвое дороже за токен, — сессии с ней в среднем подешевели на 9%, потому что Fable раньше делегирует задачи и даёт более чёткие инструкции напарнику, а Opus, наоборот, слишком плотно контролировал напарника и часто переделывал его работу заново. Тот же эффект работает и с напарником: более сильная и дорогая модель совершает меньше ошибок и требует меньше циклов проверки — экономия на количестве попыток перекрывает разницу в цене за токен.
Установить Devin CLI можно одной командой в терминале. Для тех, кто месяцами наблюдал, как счёт за API растёт быстрее, чем продуктивность, идея «заплатить больше за модель, чтобы сэкономить в сумме» звучит как парадокс — но именно на нём Cognition строит следующий раунд гонки кодовых агентов.