Claude Sonnet 5.5 догнала флагманы в коде и сбросила ценник вдвое
Счета за вызовы API часто остужают пыл быстрее, чем рендер-ферма успевает выплюнуть черновой драфт. Разработчики пайплайнов и арт-директоры годами балансируют на одной и той же растяжке: либо отправлять генеративные сценарии в тяжеловесный флагман и разоряться на токенах, либо соглашаться на компромиссный «средний класс». 28 сентября Anthropic выкатила Claude Sonnet 5.5, и эта привычная дилемма ощутимо затрещала по швам. Промежуточная модель вплотную подобралась к флагманской Opus 5.5 по ключевым бенчмаркам, сохранив ценник ровно в два раза ниже.
Разработчики пересмотрели баланс сил внутри своей линейки. Sonnet традиционно считался рабочей лошадкой для повседневного продакшена, пока Opus держали для штучных задач с глубоким контекстом. Теперь границы размылись. Sonnet 5.5 не просто догоняет старшую сестру — на профильных синтетических тестах она умудряется обходить признанных лидеров индустрии, выдавая генерацию заметно быстрее.
Замеры интеллекта и кодинг
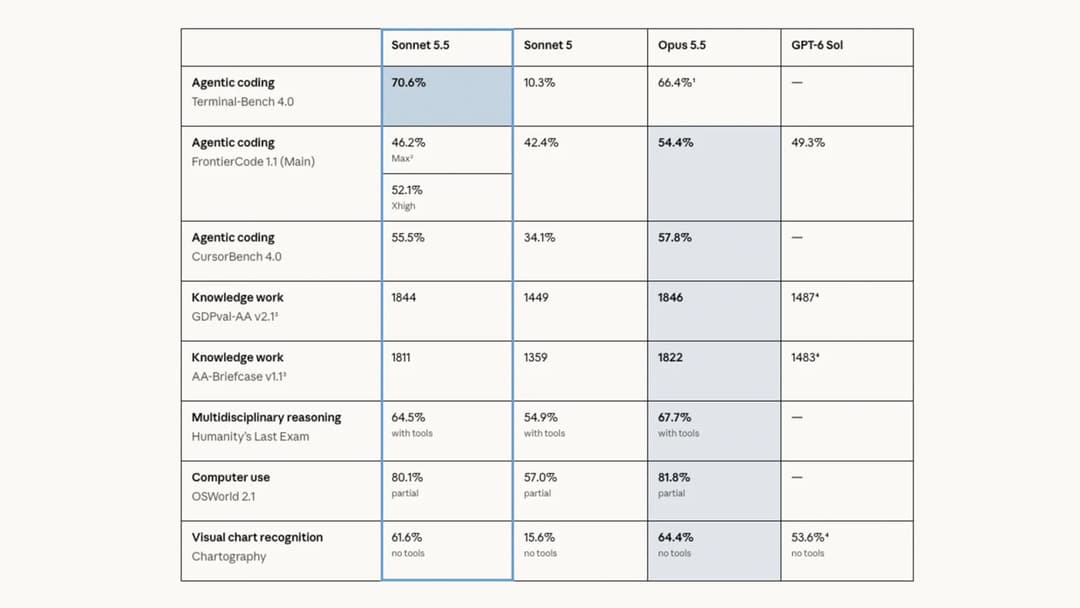
Независимые замеры Artificial Analysis показали неожиданный расклад сил. На бенчмарке Terminal-Bench 4.0, оценивающем качество написания кода, Sonnet 5.5 набрала 64%. Флагманская Opus 5.5 и конкурирующая GPT-6 Astra остановились на отметке около 60%. В тестах на автоматизацию процессов AutomationBench-AA новинка тоже слегка вырвалась вперед — 71% успешных сценариев против 70% у Opus. На общем Индексе интеллекта при максимальной нагрузке модель показала 56 баллов, уступив старшей модели всего два пункта (у Opus 5.5 зафиксировано 58 баллов).
В офисных сценариях GDPval-AA и AA-Briefcase зафиксировано практически полное совпадение результатов с флагманом. При этом важно учитывать нюанс: замеры проводились на предварительной сборке, где проявился баг структурированного вывода данных. Впереди повторный прогон тестов, но планка уже задана.
| Параметр / Бенчмарк | Claude Sonnet 5.5 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
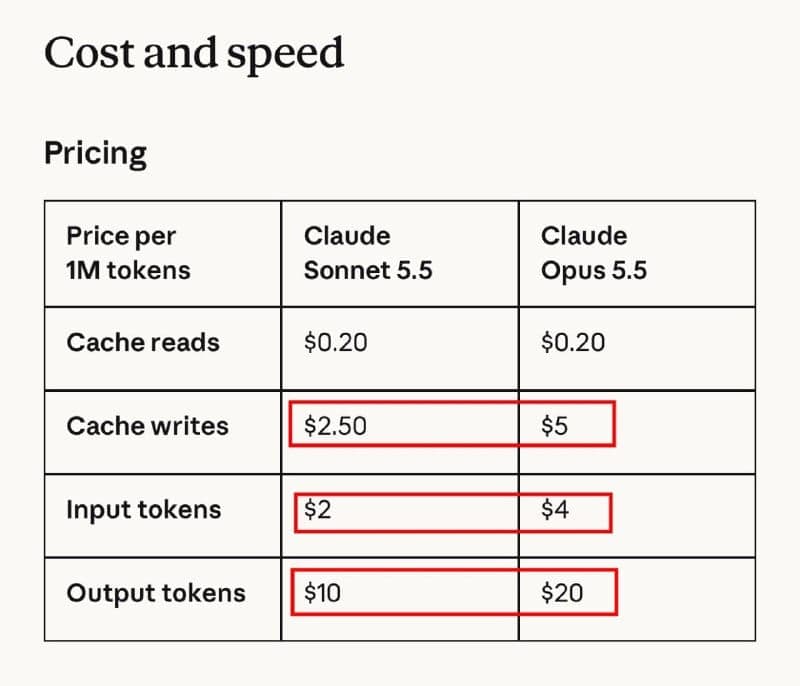
| Входные токены (за 1 млн) | $2 | $4 | — |
| Выходные токены (за 1 млн) | $10 | $20 | — |
| Кэширование (за 1 млн) | $2,50 | $5 | — |
| Terminal-Bench 4.0 (код) | 64% | ~60% | ~60% |
| AutomationBench-AA | 71% | 70% | — |
| Intelligence Index (макс. нагрузка) | 56 | 58 | — |
Экономика продакшена и скорость
Главный аргумент новинки кроется в тарифах. Anthropic сохранила базовые расценки: $2 за миллион входных токенов и $10 за миллион выходных. Для сравнения, аналогичные объемы на Opus 5.5 обходятся в $4 и $20 соответственно. Стоимость кэширования для свежих моделей зафиксирована на уровне $2,50 против $5 в зависимости от конфигурации.
По замерам создателей, генерация выходных данных ускорилась как минимум на 30% по сравнению с Sonnet 5. Благодаря оптимизации пайплайнов общие затраты на типовые сценарии снизились на величину до 30%. При максимальной нагрузке Artificial Analysis зафиксировала средний показатель около $7.60 за задачу — примерно на 50% дороже прежней Sonnet 5, что объясняется глубиной проработки. Однако в режимах низкой и средней нагрузки Anthropic обещает снижение расходов до десяти раз по сравнению с лучшими прогонами предшественницы, причем с сохранением лидерства в тестах.
Нас подкупило, как прагматично модель встраивается в рутину студий. Написание скриптов под After Effects или Blender, правка пайплайн-инструментов на Python, разбор документации и отлов мелких багов теперь не требуют переплаты за избыточные мощности. Anthropic прямо советует переводить автоматизацию документации и отладку кода на Sonnet 5.5, чтобы ускорить отклик интерфейсов и срезать счета за серверы. Opus создатели продолжают рекомендовать лишь для узкого пула задач, где требуются предельно глубокие суждения и нелинейный контекст.
Безопасность и калибровка под капотом
В релиз зашили обновленные механизмы кибербезопасности с любопытной логикой: запросы с высоким уровнем риска система автоматически перенаправляет обратно на базовую Sonnet 5. Командам разработки стоит заранее проверить, как подобные откаты к прошлой версии влияют на логику их кастомных приложений.
Командам также придется повозиться с калибровкой. Настройки уровня усиления (effort settings) требуют аккуратного тюнинга под каждый конкретный процесс. Прежде чем рисовать графики экономии в квартальных отчетах, придется внимательно замерить проценты успешного завершения задач, чистое время исполнения, реальный расход токенов, число повторных генераций и необходимость участия живого редактора.
Для креативных инженеров и арт-директоров этот релиз закрывает вечную головную боль с выбором инструмента под черновую техническую работу. Мы получаем производительность уровня флагмана по цене повседневного сырья. Хороший повод наконец переписать студийные скрипты и доверить рутину модели, которая думает быстрее и просит вдвое меньше.