Бенчмарк Edit Drift показал искажения ИИ при цепочке правок
Знакомая боль арт-директора: просишь нейросеть всего лишь перекрасить пиджак на модели в темно-синий, а она заодно меняет текстуру стены на заднем плане, стирает родинку на щеке и перекладывает тени от софтбокса. Исследователь под псевдонимом MightyKing превратил эту проблему в измеримый стресс-тест. Его новый открытый бенчмарк под названием Edit Drift проверяет, насколько аккуратно генеративные модели оставляют в покое то, к чему их вообще не просили прикасаться.
Тест устроен предельно жестко и моделирует долгую коммерческую ретушь. Берется один снимок и прогоняется через цепочку из 40 последовательных правок без передышки. Каждый следующий шаг накладывается на результат предыдущего: сменить оттенок волос, перекрасить рубашку, добавить татуировку, убрать серьгу, подрисовать пирсинг или мелкий предмет. На каждом этапе в промпт зашита одна конкретная задача и жесткое требование сохранить все остальное в первозданном виде. Чтобы выявить накопившийся дефект — так называемый дрейф пикселей, — автор зафиксировал контрольные зоны, вроде фоновой стены, и измерил их отклонение от оригинального исходника по шкале RGB от 0 до 255. Результат усредняется по всем сорока шагам в метрику Edit Fidelity Score от 0 до 100.
Результаты тестирования Milk benchmark
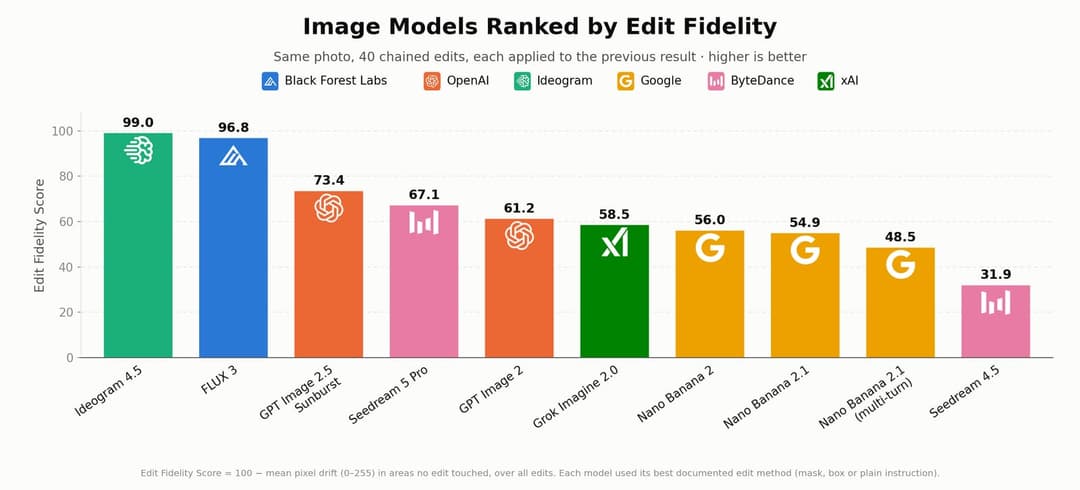
В испытаниях участвовали флагманы от Ideogram, Black Forest Labs, OpenAI, ByteDance, xAI и Google. Для каждой системы использовали самый точный из доступных официальных интерфейсов — от жестких масок и ограничивающих рамок (bounding box) до чистых текстовых инструкций при заводских настройках.
| Модель | Разработчик | Метод ввода | Edit Fidelity Score | Средний дрейф | Финальный дрейф | Дрейф за правку |
|---|---|---|---|---|---|---|
| Ideogram 4.5 | Ideogram | mask edit (high precision) | 99.0 | 1.0 | 0.7 | 0.01 |
| FLUX 3 | Black Forest Labs | box edit | 96.8 | 3.2 | 3.5 | 0.07 |
| GPT Image 2.5 Sunburst | OpenAI | mask edit | 73.4 | 26.6 | 45.3 | 0.95 |
| Seedream 5 Pro | ByteDance | plain instruction | 67.1 | 32.9 | 44.8 | 0.94 |
| GPT Image 2 | OpenAI | mask edit | 61.2 | 38.8 | 73.9 | 1.86 |
| Grok Imagine 2.0 | xAI | plain instruction | 58.5 | 41.5 | 98.4 | 2.45 |
| Nano Banana 2 | plain instruction | 56.0 | 44.0 | 94.3 | 2.46 | |
| Nano Banana 2.1 | plain instruction | 54.9 | 45.1 | 92.8 | 2.46 | |
| Nano Banana 2.1 (multi-turn) | plain instruction, multi-turn | 48.5 | 51.5 | 73.3 | 1.90 | |
| Seedream 4.5 | ByteDance | plain instruction | 31.9 | 68.1 | 65.8 | 1.41 |
Победителем вышла Ideogram 4.5 с недосягаемым баллом 99.0. Секрет ее успеха прагматичен: алгоритм аппаратно возвращает нетронутые пиксели исходника обратно на финальный холст после применения изменений. На втором месте закрепилась FLUX 3 от Black Forest Labs с результатом 96.8 балла, где редактирование велось через рамку кадрирования. Обе модели выдержали сорок итераций практически без видимого износа фона.
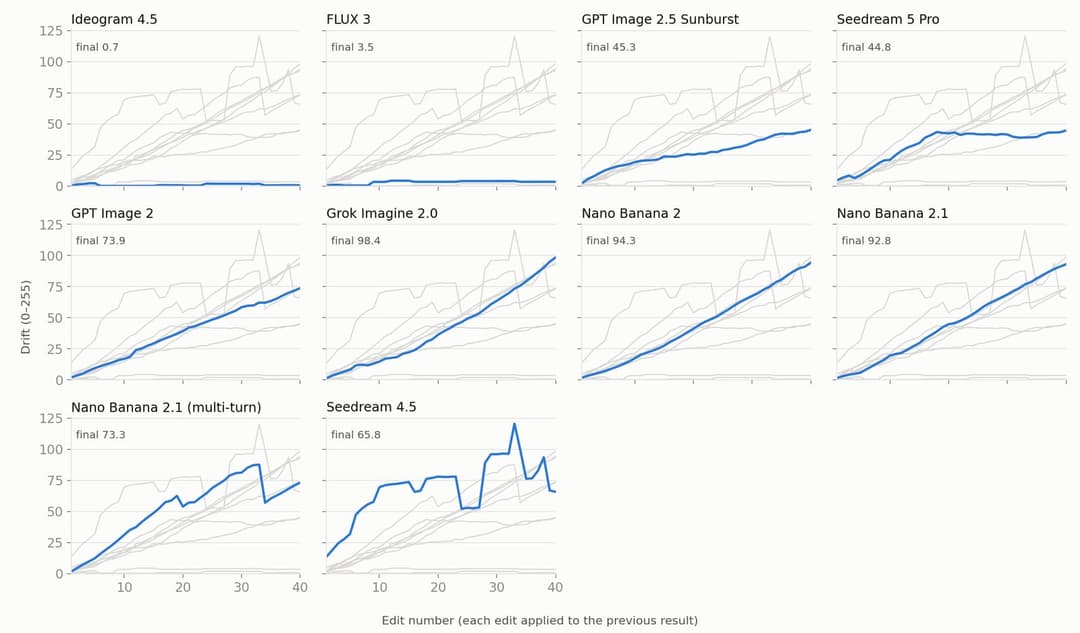
Главный сюрприз исследования — поведение систем с масками. Мы привыкли думать, что маска в инпейнте гарантирует неприкосновенность остального кадра, но это иллюзия. GPT Image 2.5 Sunburst получала точную маску на каждом шаге и все равно умудрилась перерендерить нейтральные участки, набрав 26.6 пункта среднего дрейфа и просев до 73.4 балла. Ее предшественница GPT Image 2 завершила марафон с 61.2 балла и финальным отклонением в 73.9 единицы.
Модели, которые полагаются исключительно на текстовые запросы без координатной привязки, демонстрируют линейную деградацию картинки со скоростью примерно 2.5 пункта дрейфа за каждое действие. Семейство Nano Banana от Google показало слабые результаты в районе 54.9–56.0 баллов. Фирменный многопользовательский диалоговый режим (multi-turn), который Google активно рекомендует для итераций, не исправил положение, а лишь уронил оценку Nano Banana 2.1 до 48.5 пункта. Замыкает сводку Seedream 4.5 с катастрофическими 31.9 балла.
Отдельные участники и вовсе сошли с дистанции досрочно:
- Qwen Image 3 сломалась уже после 8 правок, успев накопить дрейф 24.7;
- GPT Image 2.5 Flare споткнулась на 12-м шаге из-за собственного фильтра безопасности, выдав свыше 160 отказов подряд.
Для дизайн-команд эти замеры дают ясный ориентир при выборе пайплайна под серийную графику или работу с персонажами. Если собирать раскадровку или вносить бесконечные клиентские правки через чисто текстовый интерфейс, изображение расползется уже к пятому шагу. Для сохранения композиции и стилистики безопаснее держаться решений уровня Ideogram 4.5 или FLUX 3, где зашит механизм жесткой фиксации геометрии. Весь бенчмарк выложен в открытом репозитории на GitHub и доступен как плагин для Claude Code.
Хороший генератор помнит исходный кадр лучше, чем клиент помнит свою первую правку.