Бенчмарк Design Creativity Bench измерил пропасть между нейросетями и арт-директорами
Посадите десять начинающих верстальщиков за один бриф, и вы получите десять одинаковых карточек с круглыми кнопками. Примерно так же вели себя большие языковые модели: бодро генерировали рабочий код для сайтов, но выдавали эстетический фастфуд при малейшей попытке отойти от стандартного шаблона. Группа исследователей решила наконец оцифровать эту разницу и представила Design Creativity Bench — первый специализированный бенчмарк, который оценивает не просто способность нейросети собрать кликабельный экран, а её реальный творческий потенциал в интерфейсном и веб-дизайне.
До сих пор синтетические тесты мерили один параметр — качество финального вывода, то есть компилируется ли интерфейс и похож ли он на приличную страницу. Новый проект копает глубже. В исследовании приняли участие 16 фронтирных моделей, которым скормили 80 открытых задач по проектированию пользовательских интерфейсов. Каждое задание адаптировали сразу под два разных продуктовых домена, а результаты прогнали через прямое сравнение с эталонами, собранными руками опытных дизайнеров.
Три координаты для измерения вкуса
Вместо размытых споров о прекрасном авторы разложили интерфейсный креатив на три понятных вектора:
- Оригинальность: насколько визуальное решение конкретной модели выбивается из общей массы вариантов, которые другие системы предложили на тот же самый бриф.
- Творческий диапазон: насколько радикально алгоритм перестраивает сетку, типографику и логику взаимодействия, когда одну и ту же функциональную задачу переносят из одного продуктового контекста в другой.
- Уместность: способность сгенерированного интерфейса решать изначальную проблему и строго попадать в технические требования брифа без потери логики.
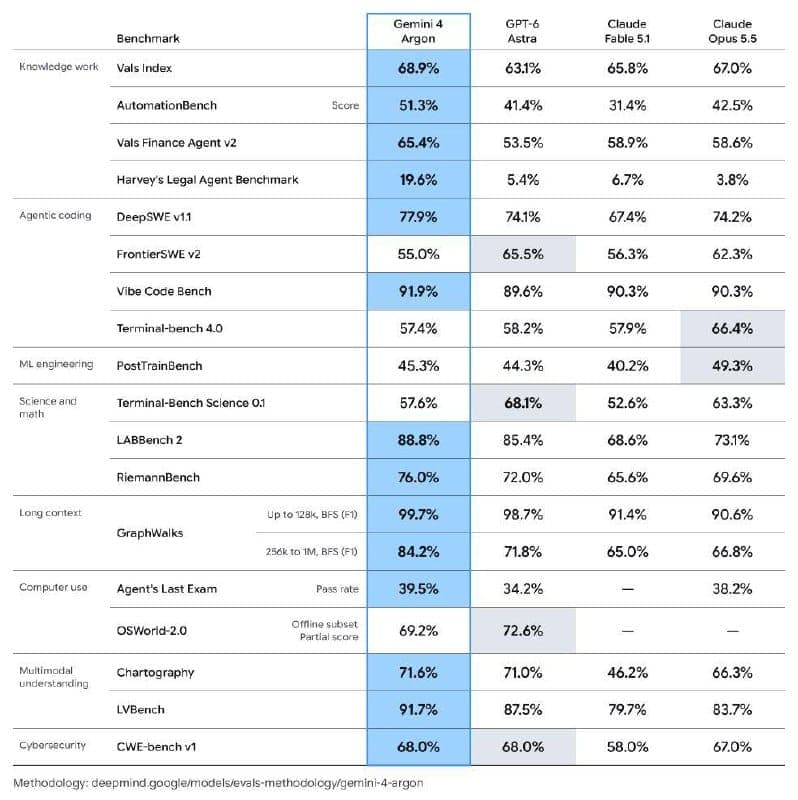
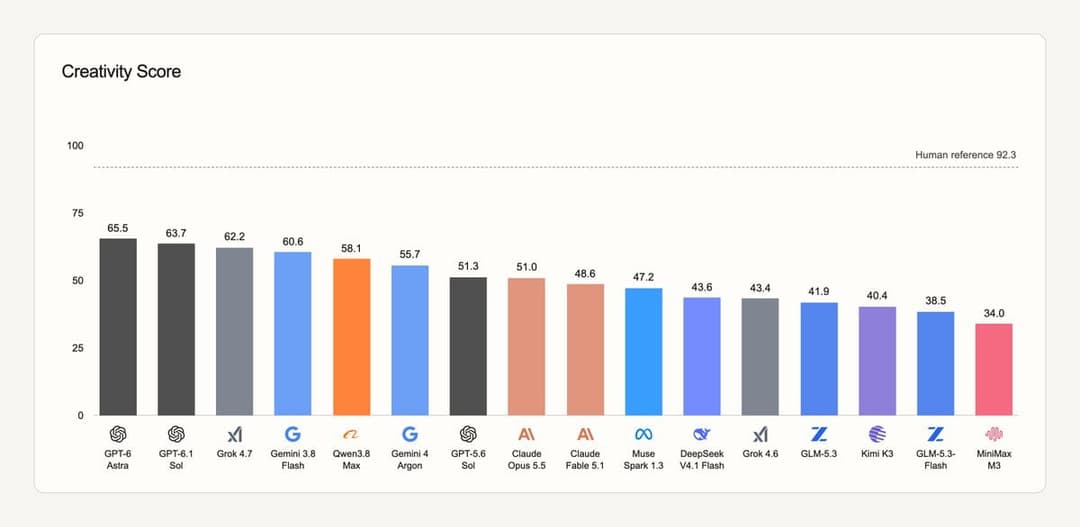
Цифры расставили всё по местам. Выяснилось, что до самостоятельного арт-дирекшна моделям пока далеко. Самый высокий балл среди шестнадцати передовых систем показала OpenAI GPT-6 Astra, набравшая всего 65.5 балла. На этом фоне эталонный уровень живых профессионалов зафиксирован на отметке 92.3 балла. Разрыв почти в тридцать пунктов наглядно подтверждает то, с чем продакшены сталкиваются каждый день на практике: модели отлично собирают базовый каркас, но мгновенно буксуют, когда от них требуют авторской смелости и нешаблонного мышления.
Всю исследовательскую базу авторы выложили в публичный доступ, превратив субъективную вкусовщину в проверяемый инженерный инструмент. Данные тестов и сам фреймворк оценки можно забрать на GitHub, полные датасеты задач опубликованы на платформе HuggingFace, а теоретическое обоснование метрик с детальным разбором экспериментов оформлено в научной публикации arXiv:2610.11539. Там же открыт полный лидерборд, где зафиксированы результаты каждого из шестнадцати участников.
Для арт-директоров и продуктовых дизайнеров эти выводы — лучший аргумент в спорах о скорой замене индустрии автогенераторами. Нейросети научились быстро верстать функциональные макеты, но по-прежнему мыслят средним арифметическим по обучающей выборке. Сгенерировать три десятка стандартных страниц под копирку машина сможет без труда, но собирать из них живой и точный продукт всё ещё придётся человеку.