Аватары Tavus обманули половину зрителей и превратили генеративное видео в диалог
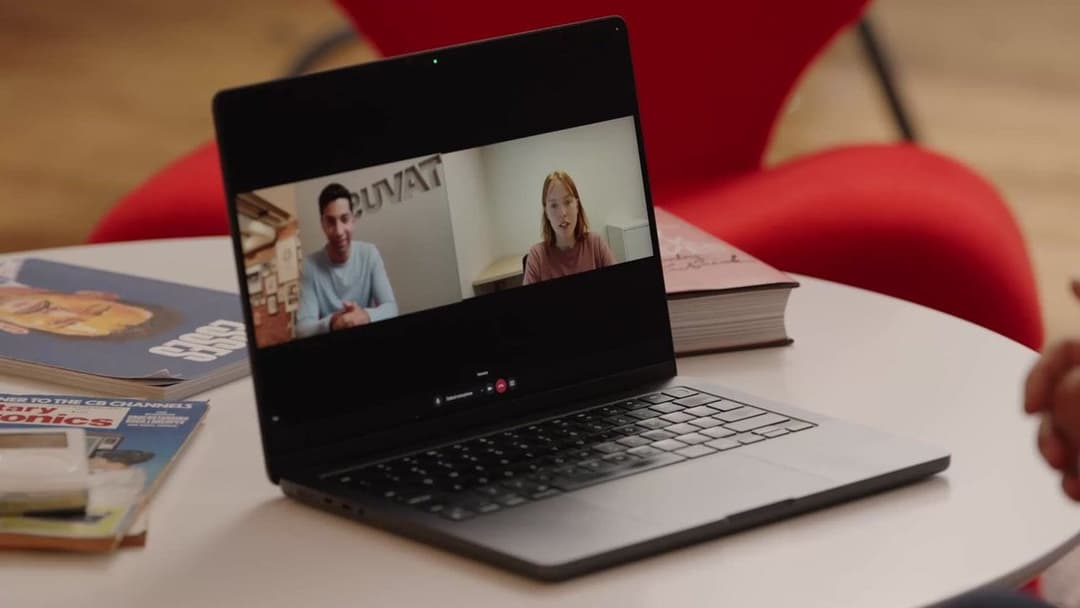
Половина собеседников в слепом тесте так и не поняла, что по ту сторону экрана с ними говорил программный код. Компания Tavus показала модель Griffin — в эксперименте на видео-Тьюринг-тестирование 48% участников приняли цифрового аватара за живого человека. Достаточно вспомнить стандартный звонок с виртуальным ассистентом, чтобы оценить дистанцию: обычно синтетический персонаж замирает в неловкой паузе, дожидается конца реплики, переваривает звук и только потом начинает механически шевелить губами. Griffin ломает этот шаблон — модель умеет слушать и говорить одновременно.
Пожалуй, именно способность не терять нить разговора, когда тебя перебивают, и создает ощущение живого контакта. Аватар Griffin видит выражение лица через камеру, слышит интонации, реагирует на реплику собеседника прямо посреди собственной фразы и не зависает в ожидании ответа сервера. Tavus называет это направлением human computing — переходом от сгенерированных заранее роликов к непрерывному взаимодействию видео-к-видео в реальном времени.
Четыре мотора под капотом
Одиночная нейросеть с такой задачей пока не справляется — слишком много разнородных процессов приходится тянуть параллельно. Чтобы картинка не рассыпалась, а диалог звучал естественно, Tavus собрала стек из четырех синхронизированных моделей:
- Sparrow 2 отвечает за логику беседы и выбор момента для реплики. Модель удерживает первую строчку в бенчмарке TurnBench: она считывает паузы, фоновый шум, мелкие междометия и интонации, избавляя ассистента от привычки перебивать невпопад.
- Phoenix 4.5 берет на себя мимику и рендеринг лица с задержкой всего 134 мс, что на 25% быстрее конкурентов. Ей не нужны многочасовые студийные съемки: модель способна генерировать новую цифровую личность в режиме zero-shot буквально по одной фотографии.
- Raven 1 служит глазами и ушами системы. Модель мультимодального восприятия параллельно обрабатывает три входящих потока — голос, видеопоток с веб-камеры и происходящее на экране пользователя. Частота обновления контекста здесь составляет менее 300 мс.
- Griffin объединяет эти сенсоры в единый цикл взаимодействия видео-к-видео. Именно она отвечает за то, чтобы аватар естественно улыбнулся на шутку еще до того, как собеседник закончит фразу.
На этой базе платформа разворачивает персональных компаньонов — PALs (Personal AI Companions). Это интерактивные аватары со своей памятью, бизнес-логикой и доступом к корпоративным базам знаний через загрузку документов. Пользователь может подключить любую собственную LLM или положиться на встроенные языковые модели компании.
Что умеет персонаж внутри видеозвонка
Если отвлечься от архитектуры, функционал аватаров выглядит как готовый рабочий инструмент для интерактивных коммуникаций:
- Полноценное участие во встречах: виртуальный персонаж подключается к звонкам в Zoom, Google Meet или Microsoft Teams на правах обычного собеседника с активной камерой.
- Презентации и браузер: аватар самостоятельно листает слайд-деки, комментирует графику, демонстрирует экран и ориентируется по страницам в веб-браузере.
- Интерфейс на лету (Magic Canvas): прямо во время диалога агент динамически генерирует интерактивные опросники, расписания или графики, подстраивая визуал под ход беседы.
- Долгая память: система сохраняет контекст между разными сессиями, избавляя от необходимости заново вводить персонажа в курс дела при следующей встрече.
Для интеграции предусмотрены разные сценарии. Разработчикам открыли доступ через CVI API (Conversational Video Interface), корпоративным клиентам предлагают заказные решения под ключ, а дизайнерам и креаторам выкатили инструмент PAL Maker — no-code конструктор, где интерактивного персонажа настраивают за несколько минут.
От сейлз-коучинга до онкологии
Нас подкупило, что Tavus сразу подкрепила анонс метриками реальных внедрений, а не только лабораторными графиками. В Salesforce запустили аватара Piper на позиции AI SDR — агент в шесть раз увеличил число запланированных встреч, удвоил вовлеченность клиентов и занял первое место в категории AI SDR на платформе G2.
В сервисе Orum развернули цифрового тренера Aurora для адаптации торговых представителей. Сроки онбординга сотрудников сократились на 50%, конверсия выросла втрое, а выручка от коучинга поднялась на 25%. Вице-президент по продукту Orum Боб Аспелл объясняет механику просто: визуальный контакт и эмоциональная связь делают разговор более ответственным, отчего практические тренировки становятся в разы эффективнее.
Еще один показательный кейс развернули Med Learning Group и Regeneron. Их агент Ruby стал первым аккредитованным ИИ-консультантом по клинической онкологии в области кожной плоскоклеточной карциномы (cSCC). Проект получил аккредитацию ACCME и AMA, повысив понимание сложных медицинских материалов среди специалистов на 65%.
Что это меняет в работе визуального продакшена
Для арт-директоров, аниматоров и моушн-дизайнеров этот релиз обозначает тектонический сдвиг. До сих пор генеративное видео в брендинге и рекламе оставалось сугубо линейным медиумом: мы часами отбирали удачные генерации, гоняли апскейлеры и сводили статичный ролик на таймлайне в After Effects или Premiere. Теперь виртуальный амбассадор бренда перестает быть запеченным видеофайлом.
Работа визуализатора смещается от финального рендера к проектированию адаптивных систем. Нам предстоит настраивать не тайминг шотов, а логику живых реакций, пластику микромимики в моменты пауз, поведение виджетов на Magic Canvas и эмоциональный диапазон персонажа при неожиданных репликах собеседника.
Когда цифровая копия человека удерживает внимание половины аудитории без единой склейки, видео окончательно перестает быть записью и становится интерактивным интерфейсом