Artificial Analysis Intelligence Index v5: открытые модели отстали на 12 баллов
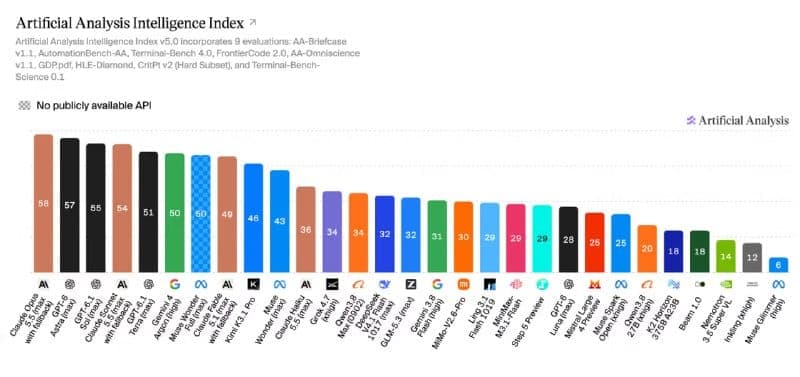
Kimi K3.1 Pro ещё недавно сидела на четвёртой строчке рейтинга. Потом Artificial Analysis выпустила пятую версию Intelligence Index, и модель съехала на девятое место: впереди восемь закрытых. Сама Kimi не изменилась, изменилась линейка, которой её мерят. Разрыв между лучшими открытыми моделями и вершиной таблицы вырос с 3 до 12 баллов.
Для тех, кто выбирает модель под продакшен, это не абстракция. Рейтинг служит ориентиром, а ориентир только что сдвинули.
Что поменяли в методике
Главное в Artificial Analysis Intelligence Index v5: 60% итогового балла теперь считается по закрытым тестовым данным или по заданиям со скрытыми ответами. Цель понятна. Так пытаются обезвредить «бенчмаксинг», когда модель натаскивают на известные вопросы публичных тестов, и она блестяще сдаёт экзамен, который все видели заранее.
В набор добавили два новых теста:
- FrontierCode 2.0: 132 реальные задачи по программированию, где оценивают качество внесённых изменений в код;
- Terminal-Bench-Science: 70 научно-исследовательских задач, которые решаются через терминал.
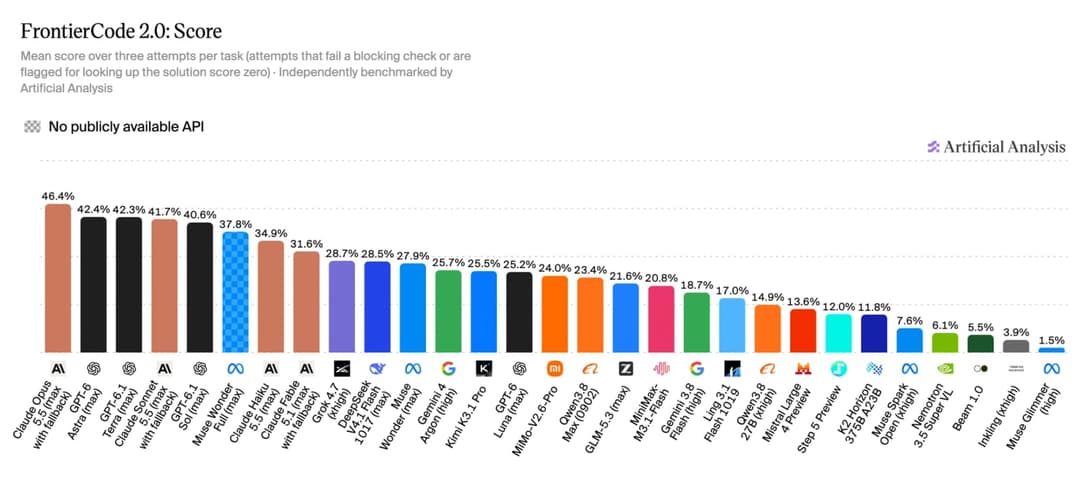
Ещё три теста обновили: HLE-Diamond, AA-Omniscience и CritPt. Рядом запустили отдельный Progress Index, он показывает, как модели прогрессировали с 2022 года.
Кто где оказался
В v5 первую тройку занимают Claude Opus 5.5 (max) с 58 баллами, GPT-6 Astra (max) с 57 и GPT-6.1 Sol (max) с 55. Gemini 4 Argon (high) набрал 50. Meta с Muse Wonder Full (max) тоже получила 50, но цены в таблице у неё нет. Дальше обрыв: Kimi K3.1 Pro — 46, а DeepSeek V4.1 Flash 1017 (max) и GLM-5.3 (max) — по 32.
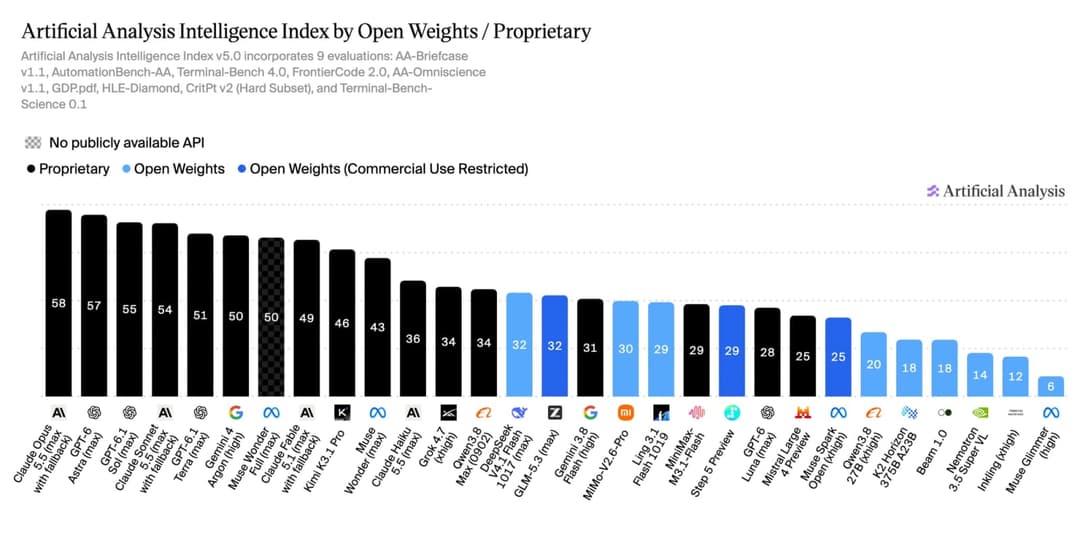
Grok 4.7 потерял в новой версии 12 баллов. В таблице его вариант high показан с 35 баллами при $6,18.
Минус 12 у Grok и плюс 9 к разрыву открытых моделей появились от одной причины, и объясняется она не только честной проверкой. Исследователь Нейтан Ламберт напоминает: значительная часть современных успехов обучения достигается в средах обучения с подкреплением на задачах, похожих на бенчмарки. Чтобы держать уровень сразу в нескольких областях, нужна сложная RL-инфраструктура, а ресурсов на неё хватает не у каждой лаборатории. Если верить этой логике, закрытые тесты не просто отсекают читерство, они ещё и показывают, у кого есть заводская мощность.
Цена задачи, а не токена
Artificial Analysis публикует и стоимость прогона задач индекса. Оговорка важная: это затраты на выполнение тестовых задач, а не цена миллиона токенов по API, и с тарифами провайдеров их напрямую не сравнить.
И всё же разница бросается в глаза. Claude Opus 5.5 (max) стоит $10,04 за задачу, GPT-6.1 Sol (max) — $1,27, GPT-6.1 Terra (max) — $0,96. Три балла между Opus и Sol обходятся примерно в восемь раз дороже.
Таблица лидеров показывает, как балл и цена растут вместе с режимом рассуждения:
| Модель | max | xhigh | high | medium | low |
|---|---|---|---|---|---|
| GPT-6.1 Sol | 55 / $1,27 | 52 / $0,76 | 50 / $0,59 | 46 / $0,36 | 35 / $0,16 |
| Claude Opus 5.5 | 58 / $10,04 | 57 / $6,05 | 52 / $3,46 | 48 / $2,45 | 35 / $0,98 |
| GPT-6 Astra | 57 / $6,24 | 55 / $3,66 | 55 / $3,24 | 51 / $2,73 | 43 / $1,42 |
В каждой ячейке сначала балл, потом цена. Для Claude в верхних режимах в таблице стоит пометка with fallback. У GPT-6 Astra режимы xhigh и high дают одинаковые 55 баллов, но второй дешевле: $3,24 против $3,66. Sol в режиме high набирает 50 за $0,59, то есть столько же, сколько Gemini 4 Argon (high), которому нужно $3,84.
В нижней части таблицы цены падают до копеек: GPT-6 Luna (max) даёт 28 баллов за $0,15, Claude Haiku 5.5 (max) — 36 за $0,41. У многих моделей, особенно с меньшим контекстом и открытыми весами, в таблице вместо значений прочерки. Полного списка в доступном фрагменте нет, он обрывается на Doubao Seed Code. Три числа в каждой строке остались без подписей, поэтому мы их не трактуем.
Цена закрытых дверей
У приватных тестов есть и обратная сторона. Внешние исследователи больше не могут сами находить ошибки в промптах и заданиях: тест не виден, значит, и проверить его нельзя. Пример уже есть. Готовя новый индекс, команде Artificial Analysis пришлось самой чинить двусмысленные и некорректные вопросы в AA-Omniscience. Кто проверяет проверяющих, пока открытый вопрос.
Что это меняет в работе
Если вы строите пайплайн на открытой модели ради контроля и цены, 12 баллов отставания стоит держать в голове, но не принимать за приговор. Индекс меряет общие способности, а не вашу задачу: раскадровку, описание сцены, генерацию кода для шейдера. Для таких вещей собственный небольшой набор образцов честнее любого рейтинга.
Если же вы выбираете закрытую модель, смотрите не на строчку, а на режим. Разница между max и xhigh у Opus — один балл при разнице в $3,99 за задачу. Мы бы попробовали ради интереса прогнать свои рабочие кейсы на двух соседних режимах и сравнить результат глазами, а не по таблице.
Пока лаборатории учатся сдавать закрытые экзамены, у вас остаётся единственный экзамен, которому можно верить: ваш собственный.