NVIDIA Nemotron 3 Nano Omni
Открытая мультимодальная модель, объединившая зрение, слух и понимание текста в одной системе
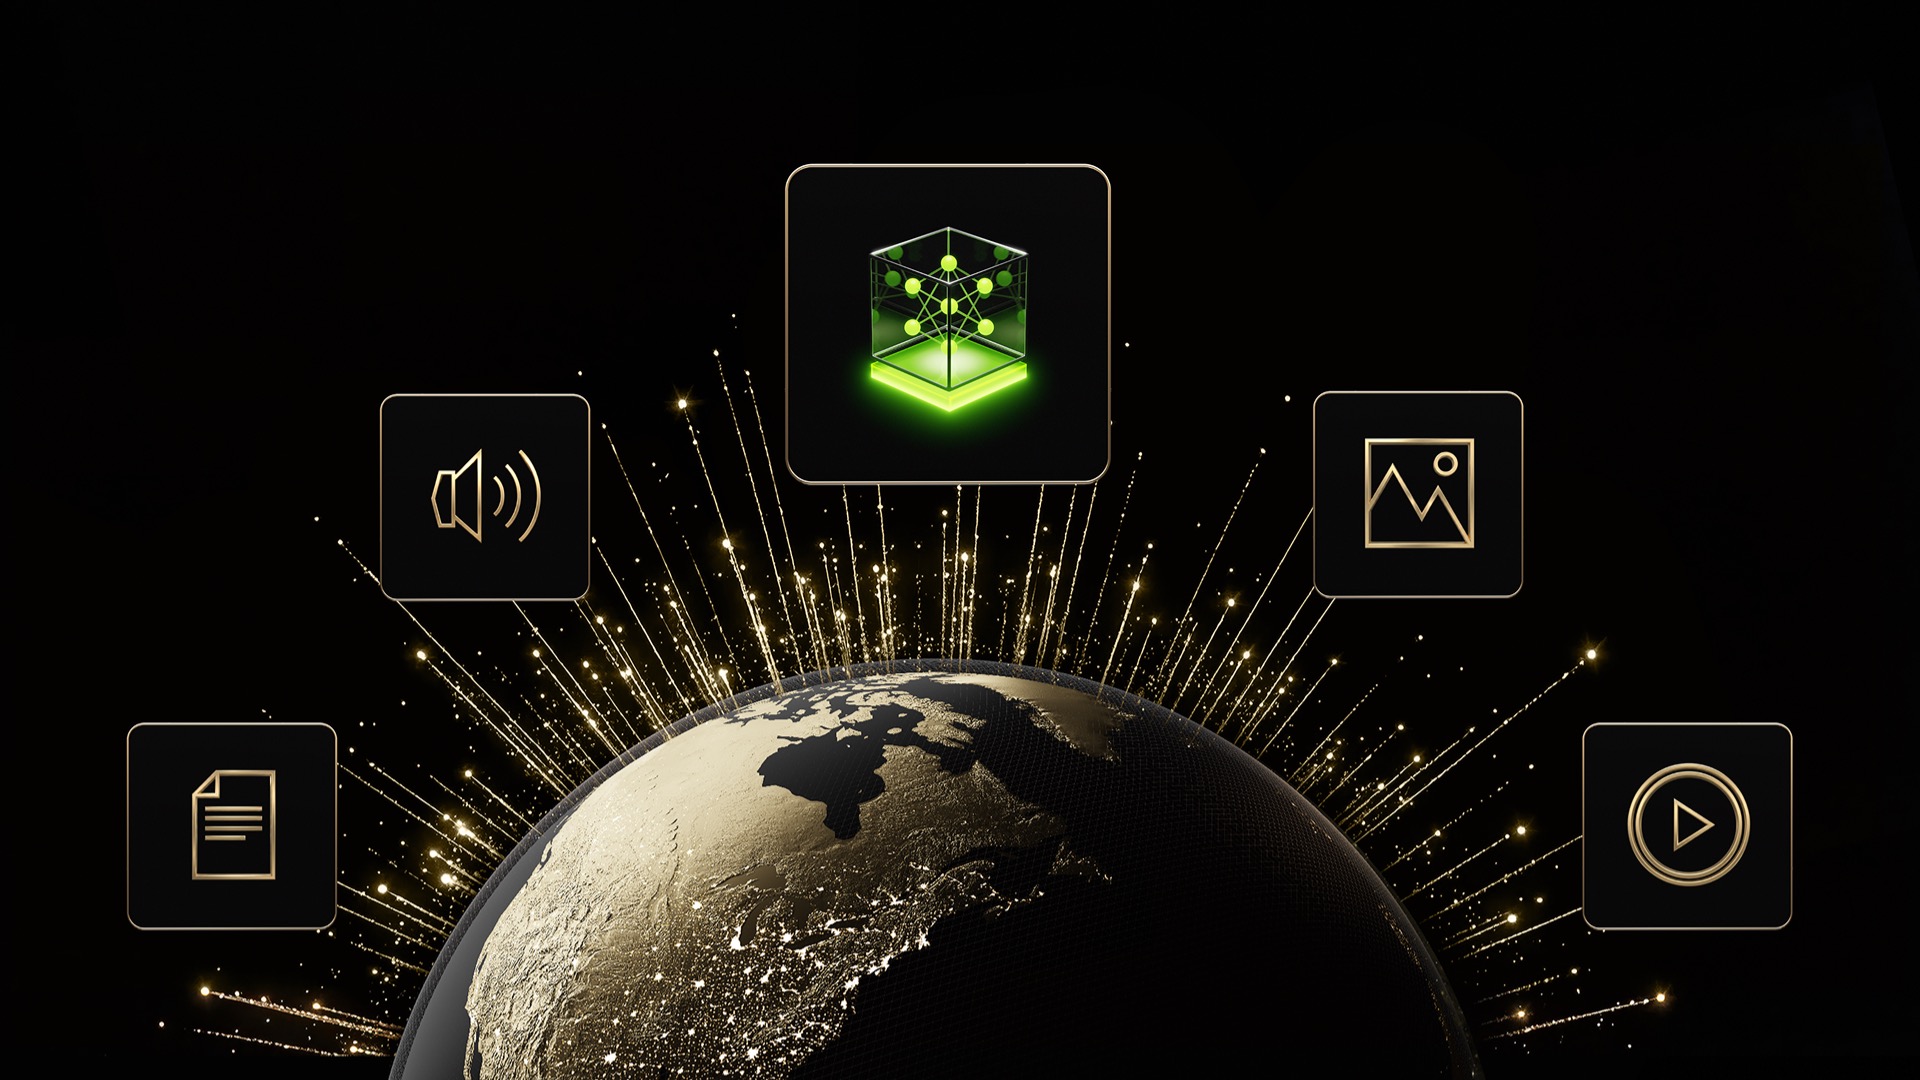
Обычно агентным системам приходится жонглировать тремя отдельными сетями: одна слушает звук, вторая распознает картинку, третья генерирует текст. На передаче контекста между ними теряется темп. Nemotron 3 Nano Omni объединяет эти функции внутри одной гибридной архитектуры Mixture-of-Experts на 30 миллиардов параметров (30B-A3B), убирая задержки на стыках разных модальностей.
Что умеет
- Разбирать Full HD в реальном времени. Модель нативно считывает видеозаписи экранов с разрешением 1920×1080 точек, отслеживая состояние графических интерфейсов и мелкие элементы управления.
- Связывать звук и видеоряд. Синхронизирует то, что было сказано, показано на экране и записано в логах, превращая эти потоки в цельное рассуждение без потери деталей.
- Анализировать сложную документацию. Читает диаграммы, таблицы, скриншоты и смешанные медиафайлы с сохранением визуальной структуры.
- Держать скорость. Архитектура обеспечивает девятикратный прирост пропускной способности по сравнению с аналогичными открытыми омни-моделями при сохранении интерактивности.
- Работать ведомым агентом. Модель рассчитана на параллельную работу с облачными проприетарными системами или старшими версиями линейки — Nemotron 3 Super и Nemotron 3 Ultra.
Цены и доступ
Веса, датасеты и методы обучения выложены в открытый доступ. Запустить модель можно через платформу build.nvidia.com в виде микросервиса NVIDIA NIM, в каталоге Hugging Face или на OpenRouter. Архитектура адаптирована для локального железа уровня плат NVIDIA Jetson и станций DGX Spark / DGX Station, а для дообучения под конкретные задачи доступен инструментарий NVIDIA NeMo.
Нас подкупила точность работы с экраном в честном 1080p — для настройки автономных помощников и разбора интерфейсных сценариев сквозной визуальный контекст решает почти все. Инструмент наконец видит рабочий стол так же цельно, как живой оператор.