Critique
Двухэтапное исследование в Copilot: одна модель пишет черновик, вторая проверяет факты и логику
Один искусственный интеллект собирает фактуру, а второй методично перепроверяет каждую сноску и формулировку. Команда Microsoft встроила в агента Researcher архитектуру Critique, разделившую сбор информации и оценку между моделями разных лабораторий — Anthropic и OpenAI. Пока первый алгоритм ведет поиск и пишет черновик, второй выступает строгим рецензентом. По-нашему, передача фактчекинга независимому «соавтору» делает отчеты заметно надежнее привычных ответов из одного окна.
Что умеет
- Разделять генерацию и критику: черновой отчет собирается одной моделью, после чего второй алгоритм дорабатывает подачу и отсеивает слабые аргументы.
- Держать дисциплину источников: система требует жесткой привязки каждого ключевого тезиса к проверяемым ссылкам и оценивает репутацию найденных площадок.
- Углублять контекст: модель-рецензент заполняет пробелы в аналитике, выравнивает логику повествования и усиливает структуру текста.
- Запускать совет моделей: режим Council генерирует два параллельных независимых отчета сразу, а отдельная модель-судья находит точки соприкосновения и расхождения во мнениях.
Доступ
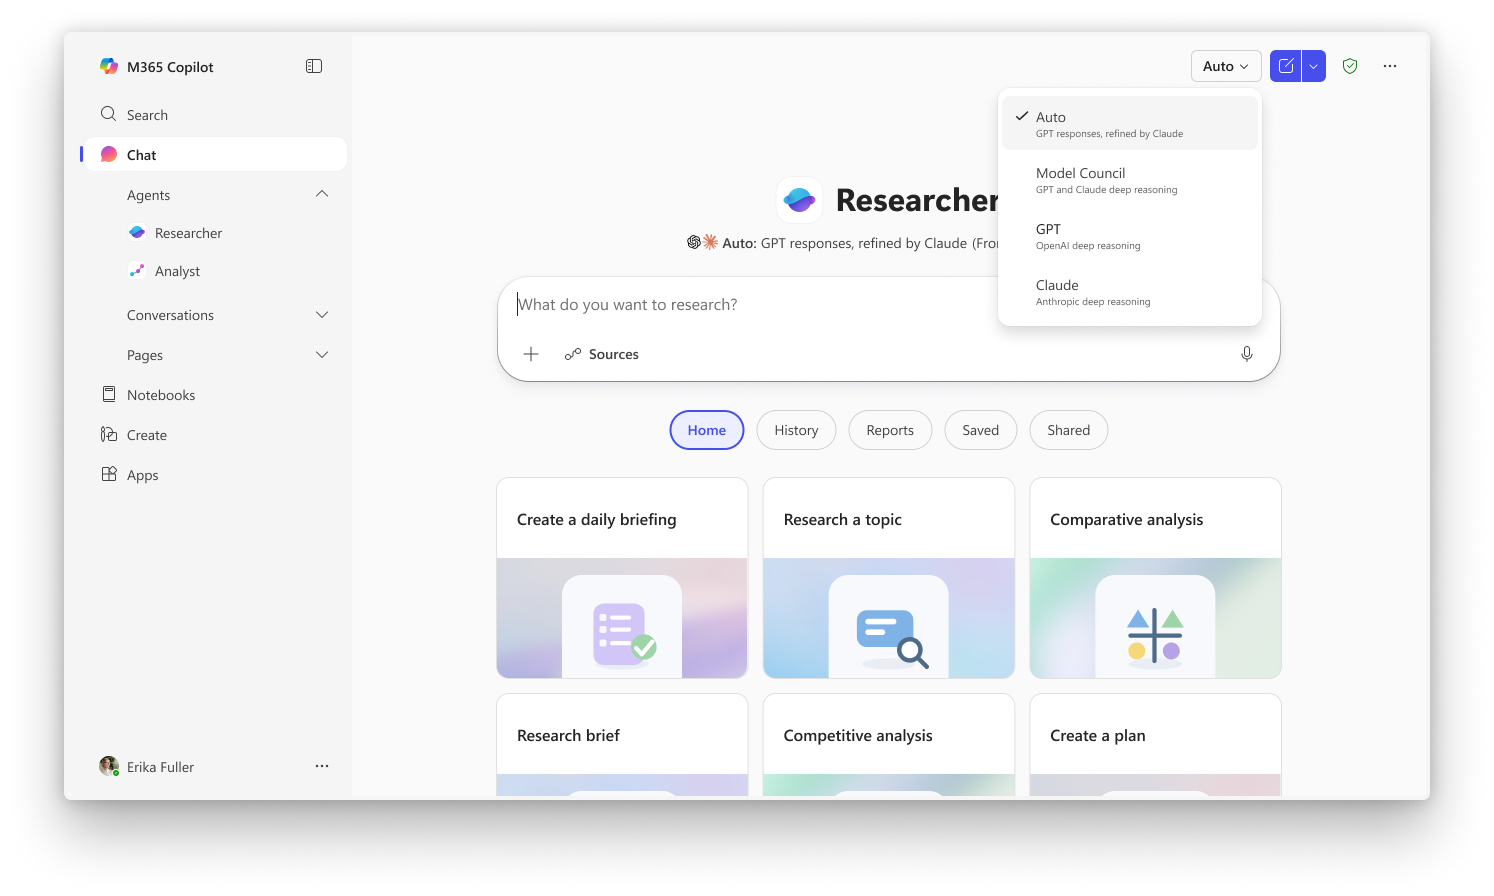
Critique и Council открыты в рамках программы Frontier для Microsoft 365 Copilot. Режим Critique работает по умолчанию, если в селекторе моделей выбрано положение Auto, а параллельный опрос включается через пункт Model Council.
Продюсерам и арт-директорам, которым часто приходится собирать глубокие справки под новые брифы и клиентские питчи, такой подход бережет часы ручной перепроверки ссылок. Когда за черновым текстом присматривает дотошный цифровой редактор, итоговой аналитике веришь сразу.